Tokenskatten – vad det kostar att tala svenska med en språkmodell
Samma text kräver 35–58 procent fler token på svenska än på engelska i två av OpenAIs tokeniserare. Det styr pris, kontextfönster och svarstid.
Av Redaktionen
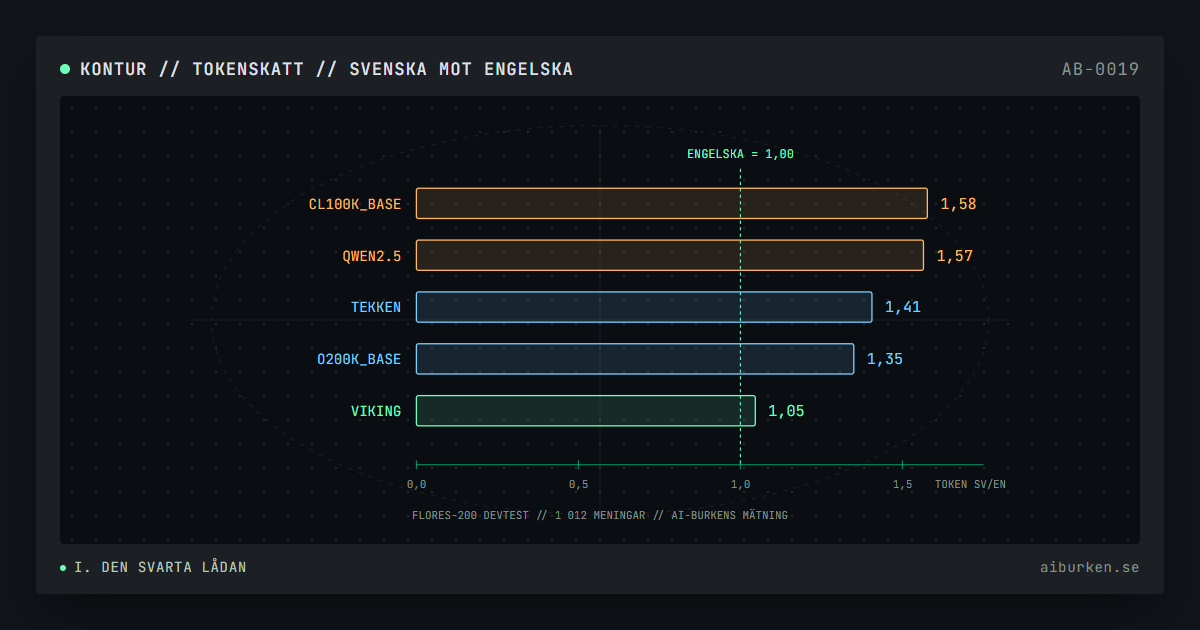
En språkmodell läser inte ord. Den läser token, bitar av text som en särskild komponent, tokeniseraren, har skurit ut innan modellen ens har börjat räkna. Det är token som avgör vad ett anrop kostar, hur mycket text som ryms i modellens arbetsminne och hur lång tid ett svar tar att skriva ut. Och samma innehåll blir olika många token beroende på vilket språk det är skrivet på.
För den här artikeln har AI-burken mätt hur stor skillnaden är för svenska. Resultatet är att en svensk text i två av OpenAIs tokeniserare kräver mellan 35 och 58 procent fler token än samma text på engelska. En nordisk modell visar samtidigt att skillnaden går att nästan ta bort, men inte gratis.
Vad en token är
En tokeniserare har ett fast ordförråd av textbitar, i de tokeniserare som mäts här mellan omkring 100 000 och 200 000. Ordförrådet byggs genom att man låter en algoritm leta efter de teckenföljder som är vanligast i en stor mängd träningstext och slå ihop dem till egna enheter. Ett ord som förekommer ofta får en egen token. Ett ovanligt ord delas i flera.
Därför spelar träningstextens sammansättning roll. Är den mest engelsk blir engelska ord hela enheter, medan andra språk får klara sig med bitar. Det engelska ordet government är en enda token i både cl100k_base och o200k_base, de två tokeniserare som OpenAIs eget bibliotek tiktoken knyter till GPT-4 respektive GPT-4o, GPT-4.1 och GPT-5. Det svenska regeringen blir tre: re, ger och ingen. Ordet myndigheterna blir fyra bitar i den äldre tokeniseraren och tre i den nyare, och arbetsförmedlingen blir fem i båda. Exemplen gäller orden skrivna med liten bokstav; med stor begynnelsebokstav kan antalet bli ett annat.
Mätningen: samma tusen meningar på sex språk
För att jämföra språk krävs samma innehåll på alla språk. Mätningen använder därför FLORES-200, ett testmaterial för maskinöversättning som Meta tog fram och som i dag förvaltas av det öppna initiativet OLDI. Delen devtest består av 1 012 engelska meningar ur Wikinews, Wikijunior och Wikivoyage, översatta till över 200 språkvarianter. Varje mening har räknats för sig, utan modellernas särskilda styrtoken, och resultaten har summerats.
En sak behöver sägas först. Den svenska översättningen är inte längre än originalet. Den har 132 173 tecken mot engelskans 131 966, och färre ord: 20 267 mot 21 901. Skillnaden i antal token beror alltså helt på hur texten delas.
| Tokeniserare | Engelska | Svenska | Svenska/engelska |
|---|---|---|---|
| cl100k_base (OpenAI, GPT-4) | 27 182 | 42 861 | 1,58 |
| o200k_base (OpenAI, GPT-4o och senare) | 26 873 | 36 287 | 1,35 |
| Qwen2.5 (Alibaba) | 27 621 | 43 240 | 1,57 |
| Tekken (Mistral NeMo) | 27 827 | 39 130 | 1,41 |
| Viking (TurkuNLP, Silo AI, HPLT) | 28 579 | 29 881 | 1,05 |
Kvoten för cl100k_base stämmer med den som forskare vid Oxford publicerade 2023. Deras data, som finns öppet, ger 83 368 token för svenska mot 52 835 för engelska, också det en kvot på 1,58. Det är ett tecken på att mätningen är gjord på samma sätt.
Svenska är inte ensamt. I o200k_base får danska kvoten 1,40, norska 1,35, tyska 1,31 och finska 1,56. Med cl100k_base kräver finska nästan dubbelt så många token som engelska, 1,99 gånger.
Tre kostnader i en
Premien slår mot tre saker samtidigt. Det pekade Oxfordforskarna redan ut 2023, när de visade att samma text i vissa fall kan få upp till 15 gånger så många token i ett språk som i ett annat.
Pris
De kommersiella tjänsterna tar betalt per token, för både frågan och svaret. En annan forskargrupp, som 2023 analyserade OpenAIs API på 22 språk, konstaterade just det och fann att talare av många språk betalade mer och fick sämre resultat. Med en kvot på 1,35 kostar en svensk text i en modell med o200k_base alltså ungefär 35 procent mer än samma innehåll på engelska, vid samma pris per token.
Kontextfönster
En modell kan bara hålla ett visst antal token i arbetsminnet. Med kvoten 1,35 rymmer ett fönster på 128 000 token svensk text motsvarande omkring 95 000 engelska token. Med 1,58 blir det omkring 81 000. För den som klistrar in en lång utredning eller ett avtal är det skillnaden mellan att hela dokumentet ryms och att slutet klipps bort.
Samma effekt syns tydligare i språk med större premie. En studie från augusti 2026, som mätte 120 felsökningsuppgifter i Python översatta från engelska, räknade ut att bengali kräver 1,56 gånger så många GPT-4o-token som engelska, och att ett fönster på 128 000 token därmed i praktiken motsvarar 82 000.
Tid
Modellen skriver ut sitt svar en token i taget. Ett svenskt svar på 400 ord blir därför fler steg än ett engelskt med samma innehåll, och tar längre tid att generera vid samma hastighet per token.
Glappet har krympt, men inte försvunnit
Premien sjunker från 1,58 till 1,35 mellan OpenAIs två generationer. Den nyare tokeniseraren har ett ungefär dubbelt så stort ordförråd, 200 019 enheter mot 100 277, vilket ger plats för fler icke-engelska ord och ordbitar. Mistral beskriver sin tokeniserare Tekken på liknande sätt: den är tränad på mer än 100 språk och enligt företaget omkring 30 procent effektivare än den tidigare för bland annat tyska, franska och spanska. I mätningen hamnar den mellan OpenAIs två.
Utvecklingen går alltså åt rätt håll för svenska, men svenskan finns inte bland de språk som Mistral själv lyfter fram när företaget beskriver förbättringen.
Vad en nordisk tokeniserare ändrar
Viking är en språkmodell som tagits fram av forskargruppen TurkuNLP vid Åbo universitet, Silo AI och det europeiska projektet HPLT, och som tränats på superdatorn LUMI i Finland. Dess tokeniserare har ett ordförråd på 131 072 enheter och är tränad på samma material som modellen: engelska, finska, svenska, danska, norska, isländska och programkod.
Resultatet syns i tabellen. Svenska kräver bara 5 procent fler token än engelska, och finska lika lite. Ett svenskt ord blir i genomsnitt 1,47 token, mot 2,11 i cl100k_base.
Men samma mätning visar priset för det. Tyska, som inte ingick i Vikings träningsmaterial, får kvoten 1,63, sämre än i alla de andra tokeniserarna. Ett ordförråd är en begränsad resurs. Varje plats som går till svenska ordbitar är en plats som inte går till något annat språk. En tokeniserare kan göra ett språk billigt, men bara genom att välja bort andra.
Det gör frågan politisk på ett sätt som inte syns för användaren. Den som bygger tokeniseraren bestämmer vilka språk som blir billiga att använda, långt innan någon har ställt en fråga till modellen.
Vem som betalar
För en enskild användare med en chattjänst till fast månadspris märks premien mindre direkt. Den märks i stället där språkmodeller används i stor skala via API: kommuner och myndigheter som sammanfattar ärenden, företag som låter en modell läsa kundmejl, utvecklare som bygger tjänster på svenska. Där multipliceras varje procent med miljontals anrop.
I ett globalt perspektiv är den svenska premien måttlig. I studien från augusti 2026 krävde joruba, trots latinska bokstäver, 2,37 gånger så många GPT-4o-token som engelska. Men det ändrar inte att svenska användare betalar mer per innehåll för samma tjänst, och att skillnaden bestäms av val som görs någon annanstans.
Det ger också ett argument i debatten om nationella och nordiska språkmodeller. En egen modell kan ge kunskap om svenska förhållanden, och den kan dessutom få en tokeniserare som behandlar svenskan som ett huvudspråk.
Metod och avgränsningar
Mätningen gäller ett material: korta, redigerade meningar ur nyheter, ett uppslagsverk för barn och en reseguide. Myndighetstext med långa sammansättningar, dialog eller programkod kan ge andra kvoter. Talen gäller tokeniserarna, inte modellernas kvalitet på svenska, som är en annan fråga. Kostnaden beror dessutom på vilket pris per token en tjänst tar, och priserna skiljer sig mellan modeller.
Mätningen gick att göra med fritt tillgängliga verktyg: OpenAIs bibliotek tiktoken för cl100k_base och o200k_base och Hugging Face-biblioteket tokenizers för de öppna modellerna. Flera europeiska modeller, bland annat svenska GPT-SW3, kräver inloggning för att tokeniseraren ska kunna hämtas och ingår därför inte. Den som vill pröva sin egen text kan räkna token för ett svenskt dokument och en engelsk översättning av det med samma verktyg, och jämföra kvoten med tabellen ovan.
FAQ
Hur många fler token kräver svenska än engelska?
I AI-burkens mätning på 1 012 parallella meningar ur FLORES-200 krävde svenskan 58 procent fler token med cl100k_base och 35 procent fler med o200k_base, de tokeniserare som OpenAI använder för GPT-4 respektive GPT-4o och senare modeller.
Är det dyrare att använda en språkmodell på svenska?
Via API, där priset sätts per token, ja. Med en kvot på 1,35 kostar en svensk text ungefär 35 procent mer än samma innehåll på engelska vid samma pris per token. Fler token betyder också att mindre text ryms i kontextfönstret och att svaren tar längre tid att skriva ut.
Varför delar tokeniseraren svenska ord i fler delar?
Ordförrådet byggs av de teckenföljder som är vanligast i träningstexten. När den mest är engelsk får engelska ord egna token, medan svenska ord som regeringen eller arbetsförmedlingen delas i tre respektive fem bitar.
Har nyare modeller mindre svensk premie?
Ja, i mätningen sjönk kvoten från 1,58 i cl100k_base till 1,35 i o200k_base. Den nordiska modellen Viking, vars tokeniserare är tränad på bland annat svenska, kom ned till 1,05, men gav i stället tyska kvoten 1,63.
Kan man mäta premien själv?
Ja. OpenAIs bibliotek tiktoken och Hugging Face-biblioteket tokenizers är fritt tillgängliga. Den som räknar token för ett svenskt dokument och en engelsk översättning av det får fram kvoten för just den texten.
// Källor och referenser
- Language Model Tokenizers Introduce Unfairness Between Languages (NeurIPS 2023), Petrov, La Malfa, Torr och Bibi, University of Oxford (arXiv 2305.15425), 20 okt. 2023.
- tokenization-fairness: tokenization_lengths.csv, Aleksandar Petrov, GitHub.
- Do All Languages Cost the Same? Tokenization in the Era of Commercial Language Models, Ahia m.fl. (arXiv 2305.13707), 23 maj 2023.
- Measuring the Tokenization Premium: A Cost Audit for Underserved Language Communities, Roy, Roy och Patel (arXiv 2608.09046), 10 aug. 2026.
- FLORES+ (FLORES-200), dev och devtest, Open Language Data Initiative, Hugging Face.
- tiktoken: model.py (koppling mellan modeller och tokeniserare), OpenAI, GitHub.
- Mistral NeMo, Mistral AI, 18 juli 2024.
- Viking-7B, modellkort, LumiOpen, Hugging Face.
- Qwen2.5-7B-Instruct, tokenizer.json, Qwen, Hugging Face.
Få AI-burkens nya analyser via e-post
Du får först ett mejl där du bekräftar adressen. Varje nyhetsbrev har en länk för att avsluta prenumerationen.
Adressen sparas av AI-burken och används bara för nyhetsbrevet. Läs integritetspolicyn