816 miljarder parametrar, 42 miljarder i arbete – vad expertmodellerna flyttar från beräkning till minne
Metas modell med öppna vikter har 816 miljarder parametrar men räknar med 42 miljarder per token. Det som blir dyrt är minnet, inte beräkningen.
Av Redaktionen
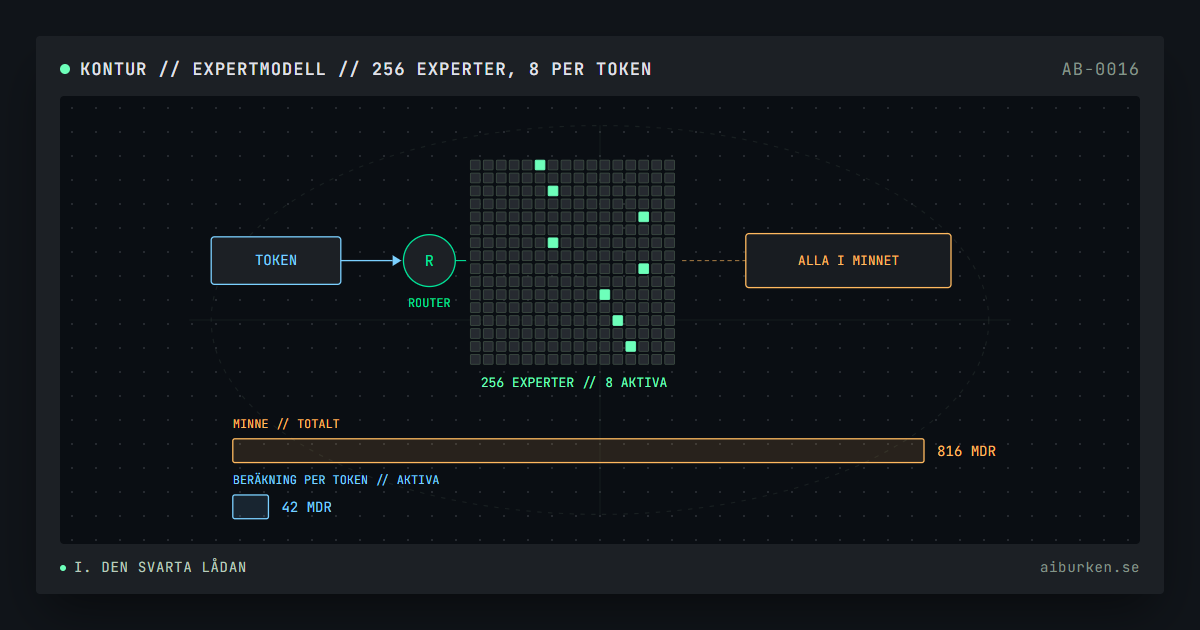
Den 15 oktober 2026 släppte Meta vikterna till Muse Spark Open, en språkmodell som enligt företaget har 816 miljarder parametrar. I samma mening anger Meta ett andra tal: 42 miljarder aktiva parametrar. Modellens namn på Hugging Face, Muse-Spark-Open-816B-A42B, bär båda talen.
Skillnaden mellan dem är inte en detalj i ett datablad. Den beskriver en arkitektur som numera bär flera av de största modellerna med öppna vikter, och den flyttar kostnaden för att köra en modell från ett ställe till ett annat. Beräkningen per ord krymper. Minnet gör det inte.
Två tal i ett modellnamn
En parameter är ett av de tal som modellen har lärt sig under träningen. I en traditionell, tät modell används alla parametrar för varje token, den textbit som modellen läser eller skriver i ett steg. En tät modell med 816 miljarder parametrar räknar alltså med alla 816 miljarder för varje token.
Muse Spark Open är byggd som en mixture of experts, en expertmodell. Enligt modellkortet har den 256 experter, och för varje token aktiveras åtta av dem. Det är därför bara 42 miljarder parametrar som deltar i beräkningen åt gången, ungefär 5 procent av helheten.
Idén är äldre än de nuvarande språkmodellerna. I artikeln om Switch Transformers från 2021 sammanfattade Googles forskare den så här: vanliga modeller återanvänder samma parametrar för alla indata, medan en expertmodell väljer olika parametrar för varje exempel. Resultatet, skrev de, blir en glest aktiverad modell med ett mycket stort antal parametrar men en konstant beräkningskostnad.
Så fungerar en router
Inne i modellen sitter en router, ett litet nätverk som för varje token avgör vilka experter som ska få den. De utvalda experternas resultat vägs sedan samman. Experterna är inte specialister i mänsklig mening, någon för juridik och någon för kod. De är delar av nätverket som träningen har gjort bra på olika mönster i datan, och routern lär sig samtidigt vart varje token bör skickas.
Mixtral 8x7B, som det franska företaget Mistral AI beskrev i en forskningsartikel 2024, är ett tydligt jämförelseexempel. Där har varje lager åtta experter, och routern väljer två per token. Varje token har tillgång till 47 miljarder parametrar men använder 13 miljarder, ungefär 28 procent. Muse Spark Open aktiverar alltså en betydligt mindre andel än Mixtral gjorde.
Siffrorna innehåller också en detalj som är lätt att missa. Åtta av 256 experter är drygt 3 procent, medan 42 av 816 miljarder parametrar är drygt 5 procent. Att den aktiva andelen parametrar är större än andelen experter tyder på att delar av modellen, utöver experterna, används för varje token. Modellkortet redovisar inte hur parametrarna fördelas mellan experterna och resten av nätverket.
Beräkningen krymper, minnet gör det inte
Här ligger poängen för den som vill köra modellen själv. Routern väljer nya experter för varje token, och det går inte att veta i förväg vilka den behöver. Alla 256 experter måste därför i praktiken finnas i snabbt minne hela tiden. Mixtralartikeln säger samma sak: minneskostnaden följer det totala antalet parametrar, 47 miljarder, inte de aktiva.
Meta anger i modellkortet att Muse Spark Open kräver minst 700 gigabyte grafikminne i formatet NVFP4 och 2 terabyte i formatet BF16. Det är de två format som vikterna har släppts i.
Räkneexempel: vikterna i BF16 och NVFP4
Siffrorna går att kontrollera ungefärligt. BF16 lagrar varje parameter med 16 bitar, alltså 2 byte. NVFP4 är ett format från Nvidia som enligt företaget lagrar varje värde med 4 bitar och lägger till en gemensam skalfaktor för varje block om 16 värden, i genomsnitt 4,5 bitar per värde.
| Format | Bitar per parameter | Alla 816 miljarder | De 42 miljarder aktiva | Metas krav på grafikminne |
|---|---|---|---|---|
| BF16 | 16 | cirka 1,6 TB | cirka 84 GB | 2 TB |
| NVFP4 | 4,5 | cirka 459 GB | cirka 24 GB | 700 GB |
Tabellen visar bara vikterna. Metas krav ligger över dem, och modellkortet förklarar inte skillnaden. En del av den går normalt åt till arbetsminnet, bland annat det som håller sammanhanget i en lång konversation och som växer med textens längd. Muse Spark Open klarar enligt Meta ett sammanhang på en miljon token.
Vad det betyder för vem som kan köra modellen
När en språkmodell skriver text är det ofta minnets bandbredd, hur snabbt vikterna kan läsas, som sätter gränsen. För varje ny token behöver i grova drag de aktiva vikterna läsas från minnet en gång.
Meta skriver i lanseringen att modellen kan köras på två Mac Studio med M5 Ultra, med upp till 512 gigabyte minne och 1,2 terabyte per sekund i minnesbandbredd vardera. Två sådana datorer har tillsammans 1 024 gigabyte, alltså mer än de 700 som Meta anger för NVFP4.
Ett förenklat räkneexempel visar vad expertarkitekturen gör för hastigheten. Med 24 gigabyte aktiva vikter per token och 1,2 terabyte per sekund blir det teoretiska taket omkring 50 token per sekund. Om alla 459 gigabyte i stället hade behövt läsas för varje token, som i en tät modell av samma storlek, hade taket legat runt 2,6 token per sekund. Räkneexemplet bortser från överföringen mellan de två datorerna, arbetsminnet och själva beräkningen. Det är ett tak, inte en mätning, och verklig hastighet blir lägre.
Slutsatsen är ändå tydlig. Expertarkitekturen gör en mycket stor modell möjlig att köra i en takt som går att använda, på hårdvara som en organisation kan köpa och ställa i ett eget rum. Men tröskeln är minnet. Med samma räknesätt tar vikterna för en tät modell med 300 miljarder parametrar cirka 170 gigabyte i NVFP4, mindre än hälften av Muse Spark Opens 459. Ändå räknar den täta modellen med drygt sju gånger fler parametrar per token.
Öppna vikter, villkorad licens
Meta beskriver Muse Spark Open som en modell med öppna vikter, inte som öppen källkod. Licensen, Muse Model License, ger rätt att använda, ändra, finjustera, destillera och sprida modellen vidare utan avgift. Den ställer också villkor:
- Varje produkt eller tjänst som använder modellen, eller en modell som har byggts med hjälp av den, ska tydligt visa texten "Built with Muse Spark Open" i gränssnittet eller i dokumentationen.
- Den som säljer tillgång till modellen som tjänst, till exempel via ett API, och vars koncern har en omsättning över 20 miljoner dollar under tolv månader i följd, ska meddela Meta och ingå ett separat avtal. Intern användning, forskning och användning som en del i en egen produkt omfattas inte av det villkoret.
- En användningspolicy förbjuder bland annat skadlig kod, bedrägerier, vapenutveckling och användning för att driva kritisk infrastruktur.
Villkoren är generösa för de flesta som vill köra modellen själva. De skiljer sig ändå från licenser som Apache 2.0, som saknar intäktsgränser och inte kräver någon märkning i produktens gränssnitt. Den som bygger en tjänst på modellen behöver därför läsa licensen. Att modellen är fri att ladda ned räcker inte som svar.
Vad talen inte säger
Ingen av de två siffrorna säger hur bra modellen är. Färre aktiva parametrar betyder inte en sämre modell, och fler totala parametrar betyder inte en bättre. Hur väl routern och experterna har tränats avgör, och det går bara att bedöma genom att pröva modellen på de uppgifter den ska lösa. Metas egna testresultat är leverantörens mätningar.
Talen svarar däremot på en annan fråga, den om vem som har råd att driva modellen. Det totala talet säger hur mycket minne som krävs. Det aktiva talet säger hur mycket beräkning och minnesbandbredd varje token kostar. För den som vill köra en stor expertmodell på egen infrastruktur är minnet den högsta tröskeln, och det är det större av talen i modellnamnet som anger hur hög den är.
FAQ
Vad betyder aktiva parametrar i en expertmodell?
Det är de parametrar som används i beräkningen för en enskild token. Muse Spark Open har 256 experter och aktiverar åtta per token, vilket enligt Meta ger 42 av totalt 816 miljarder parametrar.
Varför behövs minne för hela modellen om bara en del används?
Routern väljer nya experter för varje token, så alla experter måste finnas i snabbt minne hela tiden. Minneskostnaden följer därför det totala antalet parametrar.
Hur mycket minne kräver Muse Spark Open?
Meta anger minst 700 gigabyte grafikminne i formatet NVFP4 och 2 terabyte i BF16. Vikterna i sig blir enligt ett räkneexempel cirka 459 gigabyte respektive 1,6 terabyte.
Är Muse Spark Open öppen källkod?
Meta beskriver den som en modell med öppna vikter. Licensen kräver bland annat märkningen Built with Muse Spark Open och ett separat avtal för den som säljer tillgång till modellen som tjänst och har en koncernomsättning över 20 miljoner dollar på tolv månader.
// Källor och referenser
- Introducing Muse Spark Open, The Most Capable US Open-Weight Model to Date, Meta, 15 okt. 2026.
- Muse-Spark-Open-816B-A42B – modellkort och Muse Model License, Meta via Hugging Face, 15 okt. 2026.
- Mixtral of Experts, Jiang m.fl., arXiv:2401.04088, 8 jan. 2024.
- Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, Fedus, Zoph och Shazeer, arXiv:2101.03961, 11 jan. 2021.
- Introducing NVFP4 for Efficient and Accurate Low-Precision Inference, NVIDIA, 24 juni 2025.
Få AI-burkens nya analyser via e-post
Du får först ett mejl där du bekräftar adressen. Varje nyhetsbrev har en länk för att avsluta prenumerationen.
Adressen sparas av AI-burken och används bara för nyhetsbrevet. Läs integritetspolicyn