Provet som belönar gissning – varför språkmodeller hittar på
Nio av tio granskade AI-prov ger noll poäng för ett ”vet inte”. Därför lönar det sig för en språkmodell att gissa, och provet styr vad som byggs.
Av Redaktionen
En språkmodell kan ge ett bestämt svar även när underlaget är tunt, till exempel på en fråga om en sällan omnämnd persons födelsedag. I september 2025 publicerade fyra forskare, tre från OpenAI och en från Georgia Tech, en studie som förklarar varför. Förklaringen ligger mindre i modellernas inre och mer i de prov som avgör vilka modeller som anses bra.
Studien, Why Language Models Hallucinate, är publicerad som förtryck på arXiv. Argumentet är ändå enkelt att följa, och det berör alla som läser en topplista över AI-modeller.
Ett prov där tystnad straffas
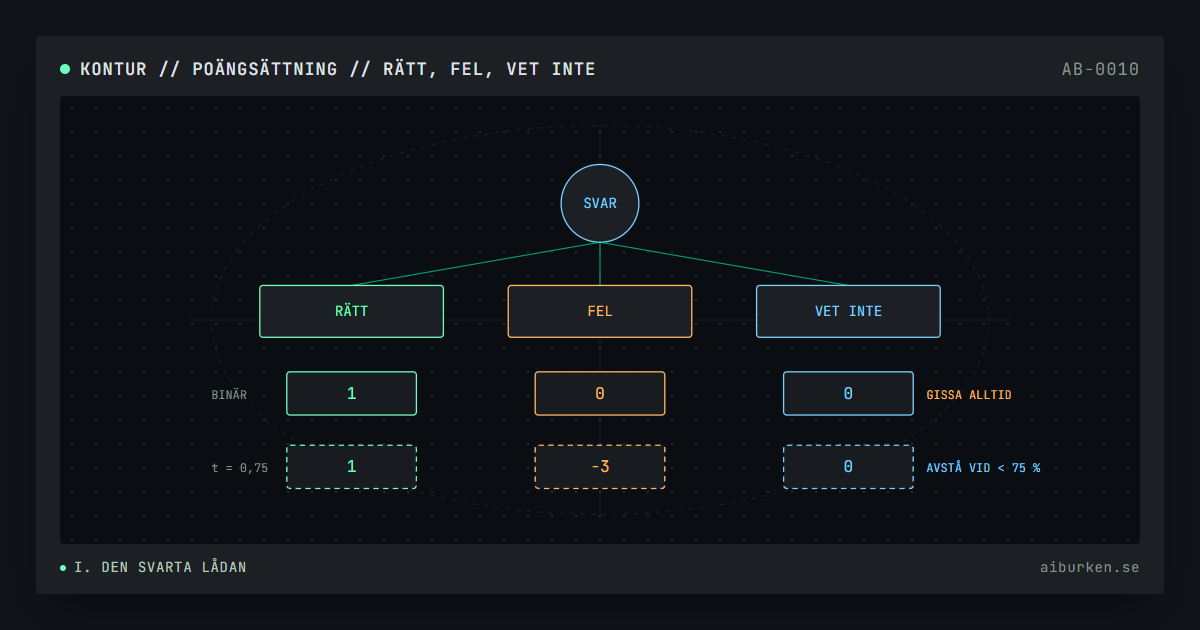
På ett flervalsprov där rätt svar ger en poäng och både fel svar och blankt ger noll gäller en enkel regel. Den som är osäker förlorar ingenting på att gissa och kan bara vinna. En elev som skriver ”vet inte” på alla osäkra frågor får ett lägre förväntat resultat än en elev som gissar, även om den första eleven vet precis lika mycket.
Författarna visar att samma logik gäller för språkmodeller. Under binär rättning, där ett svar antingen är rätt eller fel, är det att avstå enligt deras formulering ”strikt suboptimalt”. Så länge gissningen har någon chans att vara rätt ger den en högre förväntad poäng än ett ärligt ”vet inte”. Sådan poängsättning ger ett incitament att gissa när modeller tränas och väljs ut.
Frågan blir då hur vanliga sådana prov är. Författarna gick igenom tio prov som används brett för att jämföra modeller, bland dem GPQA, MMLU-Pro, SWE-bench och Humanity’s Last Exam. Nio av dem ger ingen poäng alls för att avstå. Det tionde, WildBench, bedömer svaren på en tiogradig skala, men där kan ett ”vet inte” få 3–4 poäng medan ett i övrigt hyggligt svar med faktafel får 5–6. Även det provets skala kan alltså gynna ett svar med faktafel framför att avstå.
| Svar | Binär rättning | Konfidensmål t = 0,75 |
|---|---|---|
| Rätt | 1 | 1 |
| Fel | 0 | −3 |
| Vet inte | 0 | 0 |
Förträningens statistiska gräns
Studiens andra del handlar om förträningen, då modellen lär sig förutsäga text ur stora textmängder. Där behövs inga prov för att fel ska uppstå. Författarna beskriver hallucinationer som fel i en binär klassificering: om modellen inte kan skilja ett falskt påstående från ett sant kommer den att producera falska påståenden av rent statistiska skäl.
Födelsedagar är författarnas eget exempel. Albert Einsteins födelsedag förekommer många gånger i träningsdata, och mönstret går att lära sig. En mindre känd persons födelsedag kanske bara står i en enda dödsruna. Sådana godtyckliga fakta ger inget allmänt mönster att generalisera från. En enstaka uppgift kan fortfarande memoreras; resultatet gäller en statistisk felgräns över många fakta. I studiens teoretiska modell gäller att om 20 procent av födelsedagsuppgifterna förekommer en enda gång i förträningsdatan, bör en basmodell hallucinera på minst 20 procent av dem.
Författarna prövade själva genom att fråga en öppen modell, DeepSeek-V3, om Adam Tauman Kalais födelsedag och be om svar bara om den visste. Modellen gav tre olika datum vid tre försök: 03-07, 15-06 och 01-01. Alla var fel.
Efterträningen kan förstärka gissandet
Här blir provens roll avgörande. Studien hänvisar till tidigare mätningar som visar att basmodeller ofta är väl kalibrerade: modellens sannolikheter kan stämma med hur ofta svaren är rätt i den prövade uppgiften. Det visar inte att ett uttalat säkerhetsbesked alltid är tillförlitligt.
Eftertränade modeller kan däremot avvika från den kalibreringen. I efterträningen förstärks önskade beteenden, och om det önskade beteendet mäts med prov som straffar tystnad, kan ett svar löna sig även när modellen är osäker. Författarna menar att detta bidrar till att hallucinationer överlever efterträningen.
Det förklarar också varför problemet är svårt att lösa med särskilda hallucinationsprov. Ett sådant prov kan visa att en modell gissar för mycket, men det väger lätt mot de många prov som avgör var modellen hamnar i jämförelserna. Författarna drar slutsatsen att lösningen måste ligga i poängsättningen av de prov som redan dominerar topplistorna.
När provet redan finns i träningsdatan
Provens trovärdighet har en andra svaghet som förstärker den första. Ett prov som publiceras på nätet kan hamna i nästa modells träningsdata, med frågor och ibland svar. Då mäter provet delvis vad modellen har sett tidigare, inte hur den hanterar något nytt. Fenomenet kallas kontaminering.
En studie från mars 2026 av forskarna Song med flera prövade flera modeller med brusiga, omformulerade versioner av provfrågor. De fann utbredda men varierande poängvinster över vad som kunde väntas, vilket tyder på att ledtrådar från provet kan väcka det som modellen har memorerat. Författarna föreslår inte att proven ska överges utan att resultaten ska kompletteras med uttryckliga granskningar av hur känsliga de är för kontaminering.
Tillsammans ger de två problemen en obekväm bild. En hög poäng kan delvis komma från gissningar som råkade bli rätt och delvis från frågor modellen redan har sett. Ingen av delarna syns i siffran.
Vad en ärligare poängsättning skulle kosta
Studiens förslag är att proven ska ange ett uttryckligt konfidensmål i instruktionen: modellen ska svara bara om den är mer än t säker, eftersom fel ger t/(1−t) i avdrag, medan rätt svar ger en poäng och ”vet inte” noll. Med t = 0,5 kostar ett fel en poäng, med t = 0,75 tre poäng och med t = 0,9 nio poäng. Ett mål på t = 0 motsvarar dagens binära rättning, där gissning alltid lönar sig.
Vid t = 0,75 blir avdraget 0,75/0,25 = 3 poäng. Förtrycket anger av misstag två i sitt exempel, trots att den egna formeln ger tre. Tabellen här följer formeln.
Poängen med att skriva målet i instruktionen är att det rätta beteendet blir entydigt. En modell som är 60 procent säker bör svara när t är 0,5 men avstå när t är 0,75. Författarna kallar egenskapen beteendemässig kalibrering och föreslår att den mäts direkt: väljer modellen att svara eller avstå på ett sätt som stämmer med den angivna tröskeln?
Förslaget har ett pris. En modell som avstår oftare får sämre resultat på dagens topplistor, och den som först byter poängsättning riskerar att se sämre ut än konkurrenterna. Det är ett samordningsproblem snarare än ett tekniskt problem, och det förklarar varför författarna beskriver lösningen som socioteknisk.
Det finns också en avvägning för den som använder modellerna. En modell som oftare säger ”vet inte” är mindre bekväm i vardagen, men den gör det lättare att avgöra när ett svar behöver kontrolleras. För uppgifter där ett säkert framfört fel är dyrt väger den egenskapen tyngre än en hög poäng.
Vad topplistan faktiskt mäter
Studien är huvudsakligen skriven av forskare vid ett av de företag som konkurrerar på topplistorna, och resultaten redovisas i ett förtryck. Argumentet vilar ändå mindre på deras auktoritet än på en räkning som vem som helst kan göra: när blankt ger lika lite som fel lönar sig gissning.
För den som läser en jämförelse mellan modeller ger det en konkret fråga att ställa: hur behandlas ett ”vet inte” i det här provet? Om svaret är att det räknas som fel mäter provet en blandning av kunskap och vilja att gissa. Den som ska välja en modell för uppgifter där fel kostar behöver i så fall ett eget prov, där osäkra svar får avstå och felen räknas för sig, och kan inte nöja sig med topplistans enda siffra.
FAQ
Varför hittar språkmodeller på svar?
Enligt författarna ger binär rättning ett incitament att gissa: när ”vet inte” och fel svar ger noll poäng kan en gissning höja den förväntade poängen. De menar att detta bidrar till hallucinationer.
Hur många av de granskade proven ger poäng för att avstå?
Nio av tio granskade prov ger ingen poäng alls för ”vet inte”. Det tionde, WildBench, ger delpoäng men kan ändå sätta ett ”vet inte” lägre än ett hyggligt svar med faktafel.
Kan hallucinationer tränas bort helt?
Studien ger en statistisk felgräns för basmodeller under sina antaganden. Den visar inte att varje enstaka faktum som bara förekommer en gång måste bli fel. Att låta modeller avstå är ett sätt att minska felaktiga svar.
Vad föreslår forskarna i stället för binär rättning?
Att proven anger ett uttryckligt konfidensmål t, där rätt svar ger en poäng, ”vet inte” noll och fel ger t/(1−t) i avdrag. Med t = 0,75 kostar ett fel tre poäng.
Vad är kontaminering av ett prov?
Att provfrågor och ibland svar har hamnat i modellens träningsdata. Då mäter provet delvis vad modellen redan har sett, inte hur den hanterar något nytt.
// Källor och referenser
- Why Language Models Hallucinate (arXiv:2509.04664, förtryck), Adam Tauman Kalai, Ofir Nachum, Santosh S. Vempala och Edwin Zhang (OpenAI och Georgia Tech), 4 sep. 2025.
- Silicon Bureaucracy and AI Test-Oriented Education: Contamination Sensitivity and Score Confidence in LLM Benchmarks (arXiv:2603.21636, förtryck), Yiliang Song m.fl., 28 mars 2026.
Få AI-burkens nya analyser via e-post
Du får först ett mejl där du bekräftar adressen. Varje nyhetsbrev har en länk för att avsluta prenumerationen.
Adressen sparas av AI-burken och används bara för nyhetsbrevet. Läs integritetspolicyn