Ordern och innehållet är samma text – därför går promptinjektion inte att laga
Promptinjektion liknas ofta vid SQL-injektion. Men språkmodellen saknar gränsen mellan order och data, och det avgör vad en AI-agent kan anförtros.
Av Redaktionen
I september 2022 skrev programmeraren Simon Willison om hur språkmodellen GPT-3 kunde luras att strunta i sina instruktioner. Han kallade fenomenet prompt injection, promptinjektion, och det var med hans text som namnet fick spridning. Det var lånat från SQL-injektion, en av de mest kända sårbarheterna i webbens historia. Jämförelsen var pedagogisk. Den har också visat sig vara missvisande.
I december 2025 publicerade Storbritanniens nationella cybersäkerhetscenter, NCSC, en text med rubriken Prompt injection is not SQL injection (it may be worse). Slutsatsen var att det finns goda skäl att tro att promptinjektion aldrig kommer att kunna åtgärdas på det sätt som SQL-injektion åtgärdades. Det är en ovanligt tydlig bedömning från en säkerhetsmyndighet, och den har konsekvenser för alla som bygger system där en språkmodell får läsa text utifrån och sedan agera.
Jämförelsen som lugnar fel
SQL-injektion uppstår när ett program bygger en databasfråga av text som en användare har skrivit. Skriver användaren in kod i stället för ett namn, kan databasen köra den. Lösningen är lika enkel som effektiv: parametriserade frågor. Kommandot och värdena skickas till databasen var för sig, och ett värde kan aldrig tolkas som ett kommando, vad det än innehåller. Sedan dess är SQL-injektion ett programmeringsfel. Den som drabbas har slarvat med en känd teknik.
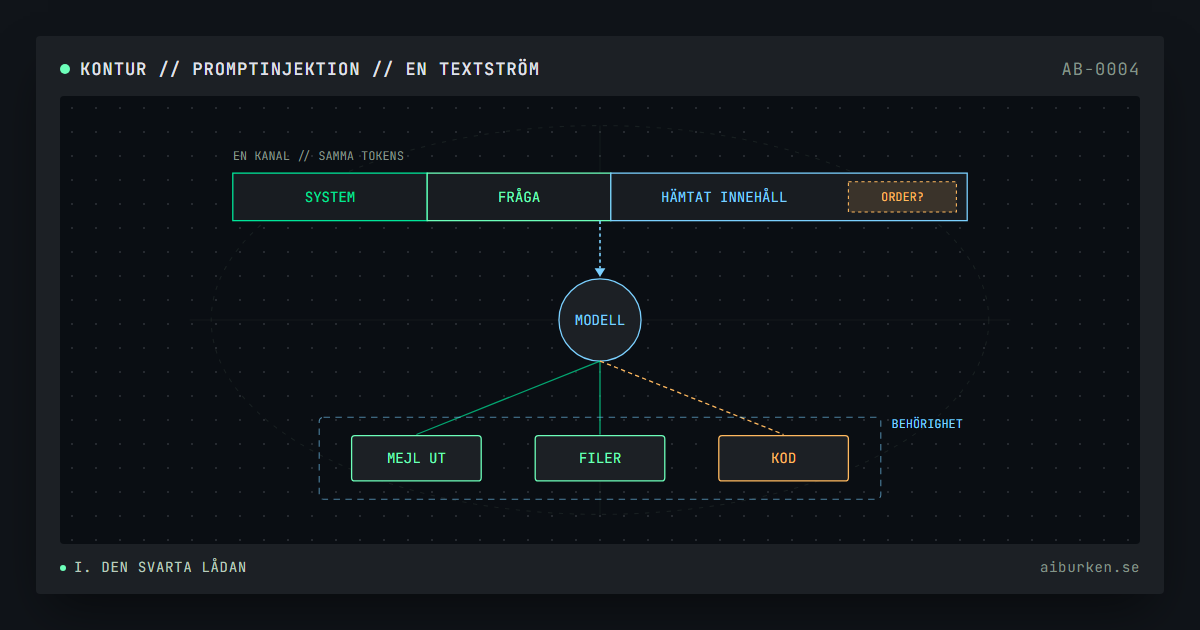
Promptinjektion ser vid första anblicken likadan ut. Text från någon utomstående behandlas som en instruktion. Men för att lösningen ska gå att flytta över krävs att mottagaren har två kanaler, en för kommandon och en för data. En språkmodell har bara en.
Varför modellen inte ser gränsen
En språkmodell tar emot en enda följd av tecken. Systemprompten med utvecklarens instruktioner, användarens fråga, innehållet i ett mejl som ska sammanfattas och texten på en webbsida som agenten har hämtat läggs efter varandra. Modellen räknar sedan fram vilket ord som sannolikt kommer härnäst. Det finns markeringar som skiljer rollerna åt, men de är själva text som modellen har tränats att ta hänsyn till. Någon spärr som garanterar att text i ett mejl aldrig kan uppfattas som en order finns inte.
En forskargrupp kring Kai Greshake beskrev 2023 den variant som har blivit mest betydelsefull: indirekt promptinjektion. Angriparen behöver inte skriva till modellen alls. Det räcker att placera instruktioner i data som modellen sannolikt kommer att läsa, till exempel en webbsida, ett dokument eller ett mejl. Program som bygger på språkmodeller suddar enligt forskarna ut gränsen mellan data och instruktioner.
Säkerhetsorganisationen OWASP placerar promptinjektion först på sin lista över de tio största riskerna i applikationer med språkmodeller. Om skydden skriver OWASP att det är oklart om det över huvud taget finns metoder som säkert förhindrar angreppen.
Fallen som visar mönstret
Ett mejl räckte
I juni 2025 blev en sårbarhet i Microsoft 365 Copilot offentlig under namnet EchoLeak, CVE-2025-32711. Ett enda manipulerat mejl kunde få assistenten att skicka känsliga uppgifter till en angripare, utan att mottagaren klickade på något. Enligt forskarnas egen genomgång kringgick angreppet flera skyddslager efter varandra: Microsofts klassificerare för att upptäcka injektionsförsök, funktionen som tar bort externa länkar och tjänstens säkerhetspolicy för innehåll, med hjälp av en proxy i Teams som policyn tillät. Microsoft har åtgärdat felet, och kunderna behövde inte göra något.
Skydden fanns alltså, men de gick att runda. En klassificerare som ska känna igen skadliga instruktioner arbetar med sannolikheter. En angripare kan formulera om sig i det oändliga, och det räcker att en variant passerar.
När verktyget litar på modellen
I maj 2026 redovisade Microsoft två sårbarheter i Semantic Kernel, företagets ramverk med öppen källkod för AI-agenter. I Python-versionen kördes ett sökfilter med funktionen eval(), och argumenten som modellen fyllde i sattes in utan sanering. En spärrlista skulle stoppa farlig kod, men den gick att kringgå (CVE-2026-26030). I .NET-versionen hade en funktion för att ladda ner filer av misstag gjorts tillgänglig för modellen, som därmed kunde skriva en fil till Windows autostartmapp och ta sig ur sin isolerade miljö (CVE-2026-25592). Båda felen är rättade.
Microsofts egen slutsats var kort: språkmodellen är ingen säkerhetsgräns. Varje parameter som modellen kan påverka ska behandlas som om en angripare hade skrivit den. Skadan uppstod inte i modellen utan i det den tilläts göra.
En förvirrbar mellanhand
NCSC föreslår ett annat sätt att tänka. Inom säkerhetsforskningen finns ett välkänt problem som kallas confused deputy: en komponent med höga behörigheter luras att utföra något åt en part som saknar dem. Klassiska fall går att åtgärda genom att ge komponenten ett sätt att avgöra vems begäran den egentligen utför. En språkmodell beskriver NCSC i stället som en mellanhand som i sig är förvirrbar. Restrisken går inte att få bort, och kan ett system inte tåla den, är en språkmodell enligt NCSC kanske fel verktyg.
NCSC återger också en princip från Willison: när en språkmodell behandlar information från en viss part, sjunker dess behörighet till den partens nivå. En assistent som läser mejl från okända avsändare bör alltså inte ha tillgång till verktyg som bara den egna organisationen borde få använda. Willison har sammanfattat risken som en dödlig trio. Den uppstår när en agent samtidigt har åtkomst till privata data, exponeras för innehåll som en angripare kan styra och kan kommunicera utåt. Hans råd är att aldrig låta alla tre egenskaperna sammanfalla.
Vad som faktiskt minskar risken
Ingen enskild åtgärd stänger problemet, men de skiljer sig åt i vad de kan åstadkomma.
| Åtgärd | Vad den gör | Begränsning |
|---|---|---|
| Märka externt innehåll, till exempel med XML-taggar | Gör det svårare för instruktioner i hämtad text att uppfattas som order | Märkningen är text; modellen kan ändå följa den |
| Klassificerare och filter | Fångar kända mönster | Arbetar med sannolikheter; NCSC avråder från spärrlistor av fraser eftersom angripare kan formulera om sig |
| Minsta möjliga behörighet och deterministiska kontroller utanför modellen | Begränsar vad en lyckad injektion kan leda till | Minskar också vad agenten kan uträtta |
| Mänskligt godkännande av riskfyllda åtgärder | Stoppar enskilda handlingar innan de genomförs | Kostar tid och skyddar bara om godkännandet är en verklig granskning |
| Loggning av indata, utdata och verktygsanrop | Gör det möjligt att upptäcka angrepp; misslyckade anrop kan avslöja att någon sonderar systemet | Upptäcker i efterhand, förhindrar inte |
Det mest intressanta försöket att gå längre kommer från forskare med kopplingar till Google. Metoden, som kallas CaMeL och presenterades 2025, låter en modell planera vad som ska göras utifrån användarens betrodda fråga. Den data som hämtas utifrån hanteras separat och kan inte ändra programmets flöde, och särskilda regler hindrar att privata uppgifter förs vidare till fel mottagare. I testmiljön AgentDojo löste systemet 77 procent av uppgifterna med bevisbar säkerhet, mot 84 procent för ett oskyddat system.
Resultatet är lärorikt på två sätt. Det visar att en lösning i stil med de parametriserade frågorna går att bygga, men att den måste byggas utanför modellen, i arkitekturen runt den. Och det visar priset: en del av det agenten annars kunde göra går förlorat.
Vad det betyder för agenter
En AI-agents nytta växer med dess åtkomst och självständighet. Fler verktyg, bredare behörigheter och mindre mänsklig inblandning gör den mer användbar. Det är också exakt de egenskaper som avgör hur stor skadan blir när modellen lyder fel avsändare.
Därför flyttas den avgörande frågan. Den lyder inte längre om modellen är tillräckligt motståndskraftig, eftersom svaret på den aldrig blir ett tydligt ja. Den lyder: vad är det värsta som kan hända om modellen gör precis det en angripare ber om? Är svaret att en sammanfattning blir fel, kan risken ofta accepteras. Är svaret att kunddata skickas ut eller att kod körs på en server, behövs spärrar som inte förutsätter att modellen fattar rätt beslut.
NCSC drar samma slutsats för den som köper in tekniken: undvik leverantörer som säger sig kunna stoppa promptinjektion, och välj dem som kan förklara hur de minskar risken. Riskägaren behöver acceptera att problemet inte går att lösa med en produkt.
Mot SQL-injektion fanns till slut en teknik som stängde hålet, och intrången berodde på att den inte användes. För promptinjektion finns ingen motsvarande teknik att införa. NCSC varnar för att en bred användning av generativ AI som inte tar hänsyn till detta kan leda till en våg av intrång liknande den som SQL-injektionen orsakade. Systemen måste därför byggas utifrån att modellen ibland kommer att luras.
FAQ
Vad är skillnaden mellan promptinjektion och SQL-injektion?
SQL-injektion går att åtgärda med parametriserade frågor, där kommando och värden skickas till databasen var för sig. En språkmodell tar emot instruktioner och innehåll som en enda följd av text och har ingen motsvarande gräns. Därför bedömer brittiska NCSC att det finns goda skäl att tro att promptinjektion aldrig kan åtgärdas på samma sätt.
Kan en bättre modell lösa problemet?
Enligt OWASP är det oklart om det finns metoder som säkert förhindrar promptinjektion. NCSC bedömer att det bästa som går att uppnå är att minska sannolikheten för och följderna av angrepp, och råder köpare att välja leverantörer som förklarar hur de minskar risken framför dem som säger sig stoppa den.
Vad är indirekt promptinjektion?
Instruktionerna kommer inte från användaren utan från innehåll som modellen läser, till exempel en webbsida, ett dokument eller ett mejl. I fallet EchoLeak i Microsoft 365 Copilot räckte ett enda manipulerat mejl, utan att mottagaren klickade på något.
Vad är den dödliga trion?
Simon Willisons beskrivning av när en AI-agent blir särskilt utsatt: den har åtkomst till privata data, exponeras för innehåll som en angripare kan styra och kan kommunicera utåt. Hans råd är att aldrig låta alla tre egenskaperna sammanfalla.
Vilka skydd rekommenderar NCSC?
Deterministiska spärrar utanför modellen som begränsar vad systemet kan göra, märkning som skiljer hämtat innehåll från instruktioner, loggning av indata, utdata och verktygsanrop samt medvetenhet hos utvecklare och riskägare om att problemet inte går att lösa helt med en produkt.
// Källor och referenser
- Prompt injection is not SQL injection (it may be worse), National Cyber Security Centre (UK), 8 dec. 2025.
- LLM01:2025 Prompt Injection, OWASP Gen AI Security Project.
- Prompt injection attacks against GPT-3, Simon Willison, 12 sep. 2022.
- Not what you've signed up for: Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection, Greshake m.fl., arXiv 2302.12173, 23 feb. 2023.
- EchoLeak: The First Real-World Zero-Click Prompt Injection Exploit in a Production LLM System, Reddy och Gujral, arXiv 2509.10540, 6 sep. 2025.
- Zero-Click AI Vulnerability Exposes Microsoft 365 Copilot Data Without User Interaction, The Hacker News, 12 juni 2025.
- When prompts become shells: RCE vulnerabilities in AI agent frameworks, Microsoft Security Blog, 7 maj 2026.
- The lethal trifecta for AI agents, Simon Willison, 16 juni 2025.
- Defeating Prompt Injections by Design, Debenedetti m.fl., arXiv 2503.18813, 24 mars 2025.
Få AI-burkens nya analyser via e-post
Du får först ett mejl där du bekräftar adressen. Varje nyhetsbrev har en länk för att avsluta prenumerationen.
Adressen hanteras av Brevo för AI-burkens räkning. Läs integritetspolicyn