När AI mäts i arbetstimmar – vad betyder agenternas tidshorisont?
En AI-agents tidshorisont mäts i människotid. Skillnaden mellan testresultat och användbart arbete avgör vad kurvorna kan säga om automatisering.
Av Redaktionen
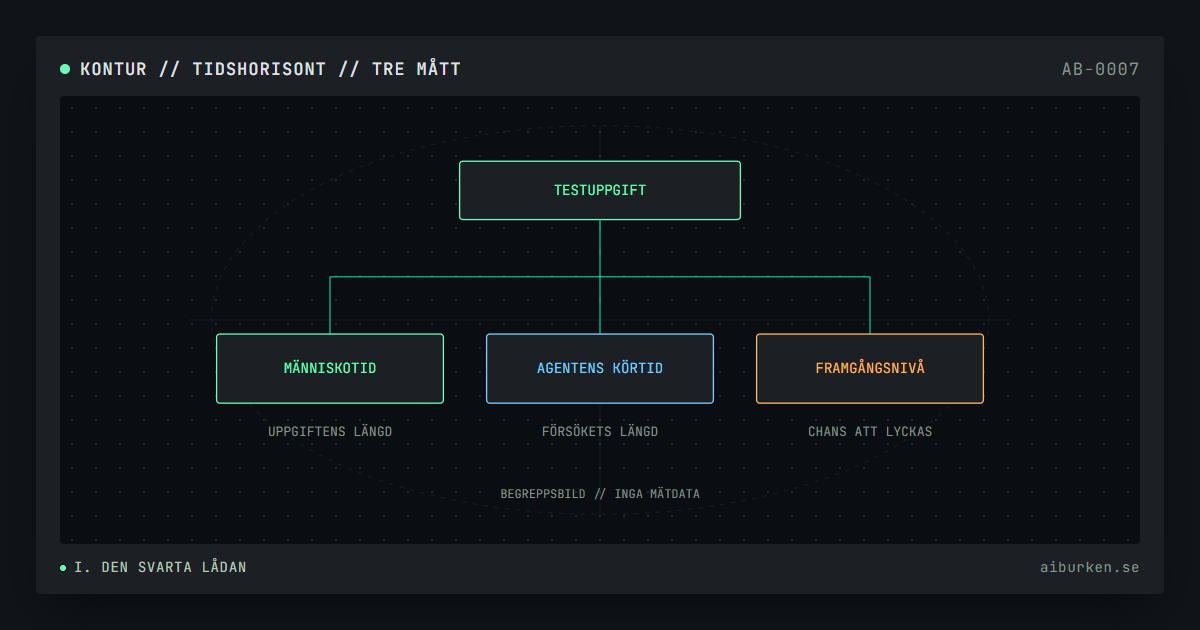
En arbetsdag är en lockande enhet för att beskriva artificiell intelligens. Den låter konkret: ett system som klarar längre uppgifter borde kunna ta över mer arbete. Men ordet timmar kan beteckna flera olika saker. En agent kan köras länge utan att leverera något användbart, eller lösa en svår uppgift snabbt. Den skillnaden är avgörande när forskningsresultat blir argument om framtidens arbetsliv.
Forskningsorganisationen METR har utvecklat ett mått som kallas uppgiftstidshorisont. I forskningsartikeln bakom måttet beskrivs tidshorisonten ha fördubblats ungefär var sjunde månad sedan 2019. Det är den sortens kurva som lätt blir en prognos om arbete. Mätsidan uppdaterades senast den 8 september 2026 och anger nu att den inte längre underhålls aktivt. Den är därför ingen löpande topplista över dagens modeller. Metoden är ändå värd att förstå: den visar både hur framsteg kan mätas och hur mycket som försvinner när ett mätetal får stå för ett helt arbetsflöde.
Människotid på diagrammets axel
Tidshorisontens utgångspunkt är hur lång tid en uppgift tar för en mänsklig expert. Agenternas försök används sedan för att skatta sannolikheten att lyckas vid olika uppgiftslängder. METR:s 50-procentstidshorisont är den mänskliga uppgiftstid där den anpassade kurvan förutsäger 50 procents framgång. Agentens egen körtid är en annan storhet. Sidan varnar dessutom för att mätningar över 16 timmar är otillförlitliga med den nuvarande uppsättningen testuppgifter.
Skillnaden kan visas med ett rent tankeförsök. Anta att en människa behöver två timmar för en avgränsad felsökning och att en agent hittar lösningen på tio minuter. Uppgiften hör då fortfarande till kategorin två timmars mänskligt arbete. Tio minuter beskriver genomförandet i just det försöket. Inget av talen visar ensamt hur ofta agenten lyckas eller hur mycket granskning lösningen kräver.
Det mänskliga tidsmåttet fungerar alltså som ett sätt att ordna uppgifternas svårighet. Det är praktiskt eftersom en svår felsökning och en svår kodändring annars är besvärliga att jämföra. Samtidigt bär måttet med sig människans förutsättningar: tidigare erfarenhet, tillgång till instruktioner och hur väl problemet är avgränsat. En timme är ingen egenskap som ligger oföränderlig inne i själva uppgiften.
Vad en lyckad uppgift betyder
Den ursprungliga forskningen om långa programvaruuppgifter ger en gemensam ram för att studera hur modeller klarar sammanhängande arbete. Men ett mått behöver ett bestämt slutvillkor. Om uppgiften är att rätta ett programfel måste utvärderingen avgöra när felet verkligen är rättat. Det kan ske med förberedda tester. Därmed går försöken att upprepa, men det som testen inte fångar kan hamna utanför resultatet.
METR undersökte skillnaden närmare i en studie som publicerades den 13 augusti 2025. Den omfattade 18 verkliga ärenden från två öppna kodarkiv och en enda agent byggd på en språkmodell från början av 2025. Agenten klarade projektens egna tester i omkring 38 procent av ärendena, med ett 95-procentigt konfidensintervall på 19 procentenheter åt vardera hållet. Ingen av de fyra godkända lösningar som granskades manuellt gick att föra in i projektet utan ändringar. Bristerna gällde bland annat testtäckning, dokumentation, formatering och kodkvalitet. Forskarna skattade efterarbetet för de godkända lösningarna till i genomsnitt 26 minuter, att jämföra med 1,3 timmar för projektens egna utvecklare att lösa ärendena från början.
Materialet är för litet för att ge en aktuell felandel för dagens agenter. Däremot synliggör det ett problem med själva frågan. Att avgöra om ett program producerar rätt svar är smalare än att avgöra om en ändring passar i ett gemensamt projekt. Underhåll, förklaringar och samspel med övrig kod kan kräva andra bedömningar. Ett tekniskt testresultat behöver därför läsas tillsammans med definitionen av en godkänd leverans.
Tillförlitligheten ändrar tolkningen
En tidshorisont utan angiven framgångsnivå lämnar en central uppgift osagd. Vid samma mänskliga uppgiftslängd kan ett resultat vara intressant som forskningssignal och otillräckligt för ett arbete som måste bli rätt varje gång. METR visar därför mått vid både 50 och 80 procents framgång. Nivåerna beskriver olika punkter på den skattade kurvan, inte olika slags arbetstimmar.
Det är frestande att läsa 50 procent som att varje enskild uppgift är ett likadant myntkast. Men en kurva sammanfattar variationen i ett material. Två uppgifter som tar en människa lika lång tid kan ställa helt olika krav på agenten. Den ena kan ha tydliga felmeddelanden och ett lättkontrollerat slut, den andra kräva en svår tolkning. Ett sammanfattande värde visar inte vilka av dessa skillnader som är avgörande i en viss verksamhet.
Som analytiskt exempel kan en ofullständig lösning vara användbar i ett idéarbete där en människa ändå väljer bland flera förslag. Samma felmarginal blir svårare att bära när ett system fattar ett beslut som omedelbart påverkar andra. Skillnaden är inte uppmätt i METR:s material, men den måste finnas med när någon försöker översätta måttet till ett beslut.
| Storhet | Vad den beskriver | Vad som behöver bedömas separat |
|---|---|---|
| Mänsklig uppgiftstid | Tidsåtgången som används för att ordna testuppgifter | Hur väl testuppgiften motsvarar arbetet |
| Agentens körtid | Hur länge ett visst försök pågår | Om försöket lyckas och vad det kostar |
| Framgångsnivå | Hur stor sannolikhet för godkänt resultat måttet avser | Vilka fel verksamheten kan bära |
Kontexten som testet saknar
METR:s uppgifter är huvudsakligen hämtade från programvaruutveckling, maskininlärning och cybersäkerhet. De är utformade för att vara självständiga och tydligt specificerade. Det gör jämförelsen mellan människa och agent möjlig. Avgränsningen är samtidigt viktig för tolkningen: ett väl beskrivet problem är redan en bearbetad version av verkligheten.
I ett fiktivt projekt kan uppgiften exempelvis heta ”rätta datumhanteringen”. Innan någon kan börja måste projektgruppen kanske avgöra vilka äldre dokument som ska stödjas, vilken kund som påverkas och vem som får ändra beteendet. När dessa frågor redan är lösta återstår ett tekniskt problem. Ett test kan mäta lösningen av det problemet utan att mäta arbetet som gjorde det möjligt att formulera uppgiften.
Här finns också ett dilemma i jämförelsen med människor. Samma instruktioner ger en tydlig experimentell utgångspunkt, men den som arbetar dagligen i ett projekt har ofta bakgrundskunskap som inte står i instruktionen. Om en sådan person används som bild för människan på diagrammet blir jämförelsen missvisande. Det avgörande är vilken mänsklig arbetssituation baslinjen faktiskt representerar.
Agenten är dessutom ett system av flera delar. Modellen samverkar med verktyg och en omgivande struktur som hanterar arbetets steg. Därför behöver ett resultat knytas till den utvärderade konfigurationen. Att en modell finns i en annan tjänst innebär inte automatiskt att samma arbetssätt, åtkomst eller förmåga har följt med.
Från avgränsad uppgift till ansvar för ett arbete
Uppföljningens mönster går att föra över till ett verkligt arbetsflöde. En agent lämnar en kodändring som klarar det tekniska testet. En kollega måste sedan läsa den, förstå ett nytt beroende och avgöra om ändringen bör införas just nu. Om den mänskliga granskningen blir mer omfattande har agenten fortfarande löst testuppgiften. Verksamheten har däremot fått ett annat förhållande mellan produktion och kontroll.
Det betyder att diskussionen om automatisering behöver fler utfall än agentens framgång. Ett användbart beslutsunderlag skulle också skilja godkända leveranser från försök, och synliggöra mänskligt efterarbete. Annars kan en ökning av tekniskt lösta uppgifter förväxlas med en lika stor ökning av färdigt arbete.
Även möjligheten att försöka igen har en kostnad som uppgiftstidshorisonten inte uttrycker. I ett forskningsförsök kan ett misslyckande registreras och följas av ett nytt försök under kontrollerade villkor. I ett arbetsflöde kan försöket redan ha ändrat något som behöver återställas. En analys av användbarheten måste då skilja mellan att producera ett nytt svar och att få tillbaka ett tillstånd där svaret säkert kan användas. Den skillnaden kan vara liten i en isolerad testmiljö och avgörande i ett sammanhängande arbete.
METR:s tidshorisont kan ge kunskap om förmågan att genomföra längre, avgränsade tekniska uppgifter. För att bedöma vad den förmågan betyder i samhället behöver nästa fråga handla om arbetets organisation: vem formulerar uppgiften, vem kontrollerar resultatet och vem tar över när det misslyckas? Där börjar analysen av automatisering som diagrammet ensamt inte kan göra.
FAQ
Vad betyder en AI-agents tidshorisont?
METR:s mått utgår från hur lång tid en mänsklig expert behöver för testuppgifter. Tidshorisonten anger den uppgiftslängd där agenten skattas lyckas vid en bestämd framgångsnivå.
Är tidshorisonten agentens körtid?
Nej. Agentens körtid beskriver hur länge ett visst försök pågår. Tidshorisonten utgår från den mänskliga uppgiftstiden.
Vad innebär 50 procents tillförlitlighet?
50-procentstidshorisonten är den mänskliga uppgiftstid där den anpassade kurvan förutsäger 50 procents framgång. Det är ett sammanfattande mått och innebär inte att varje uppgift är ett likadant myntkast.
Kan måttet översättas till hela arbetsdagar?
Inte direkt. Testuppgifterna är avgränsade och gäller huvudsakligen tekniskt arbete. Uppgiftsformulering, sammanhang, kontroll och mänskligt efterarbete behöver bedömas separat.
// Källor och referenser
- Task-Completion Time Horizons of Frontier AI Models, METR, 8 sep. 2026.
- Measuring AI Ability to Complete Long Software Tasks, version 4, Thomas Kwa med flera, METR / arXiv, 10 juli 2026.
- Research Update: Algorithmic vs. Holistic Evaluation, METR, 13 aug. 2025.
Få AI-burkens nya analyser via e-post
Du får först ett mejl där du bekräftar adressen. Varje nyhetsbrev har en länk för att avsluta prenumerationen.
Adressen hanteras av Brevo för AI-burkens räkning. Läs integritetspolicyn