Webben som äter sig själv – vad modellkollaps betyder för nästa generation språkmodeller
Nästan en fjärdedel av webbsidorna innehåller nu AI-text. Studier visar att kollaps kan undvikas i vissa uppställningar och att det sällsynta försvinner först.
Av Redaktionen
Före 2022 innehöll nästan inga webbsidor text som en språkmodell hade skrivit. I augusti 2026 gällde det ungefär var fjärde. Det är huvudresultatet i en studie som publicerades som preprint den 27 oktober 2026. Forskare från bland annat UC Berkeley och University of Washington har gått igenom drygt fem miljoner sidor ur webbarkivet Common Crawl och skattar att 24 procent av de crawlbara sidorna innehöll AI-genererad eller AI-redigerad text.
Webben är råvaran för språkmodeller. Varje ny modellgeneration tränas i stor utsträckning på text som samlats in därifrån, och allt större del av den texten har skrivits av tidigare modeller. Forskningen har ett namn på vad som kan hända då: modellkollaps.
Experimentet som gav fenomenet ett namn
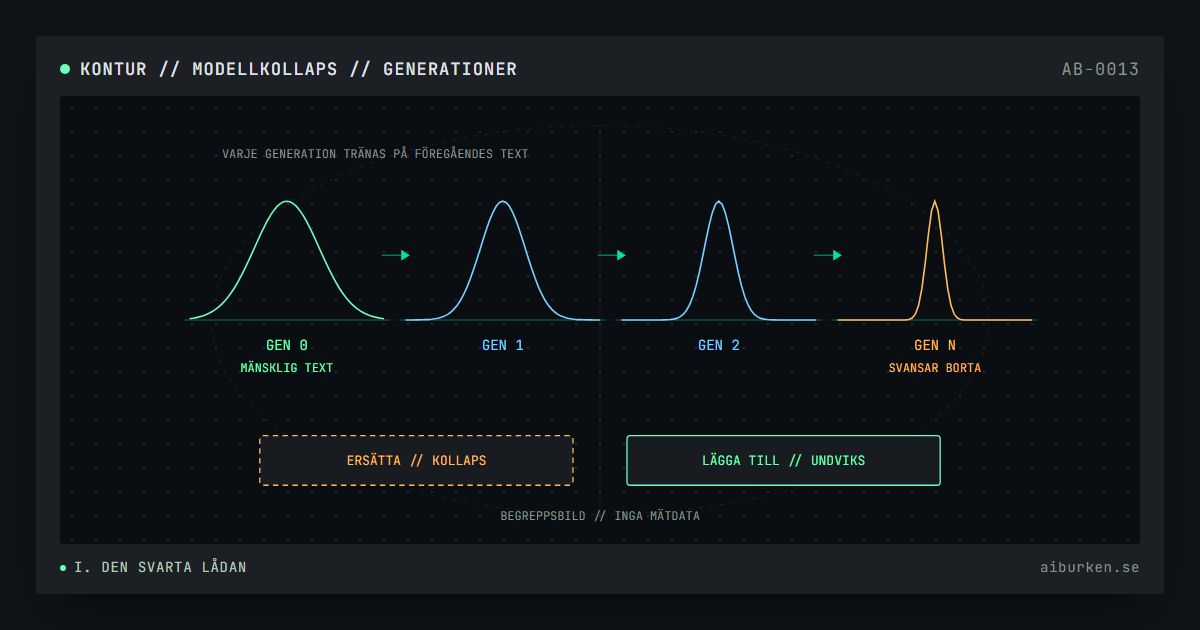
Begreppet fick sitt genomslag med en artikel i Nature i juli 2024 av Ilia Shumailov och kollegor. Slutsatsen i sammanfattningen är skarp: när modellgenererat innehåll används okritiskt i träning uppstår bestående defekter i de nya modellerna, och svansarna i den ursprungliga fördelningen försvinner.
Svansarna är det ovanliga i ett material: sällsynta ord, udda formuleringar och händelser som sällan förekommer. Forskarna skiljer mellan två stadier. I den tidiga kollapsen börjar modellen tappa information om svansarna. I den sena kollapsen har modellen glidit mot en fördelning som liknar originalet dåligt och ofta har betydligt mindre variation.
Själva försöket var litet. Forskarna finjusterade Metas språkmodell OPT-125m, med 125 miljoner parametrar, på textsamlingen wikitext2. Därefter tränades varje ny generation på text som den föregående generationen hade producerat. När ingen originaldata fanns kvar försämrades modellens förmåga att förutsäga text tydligt: perplexiteten, ett mått där lägre är bättre, steg från omkring 20 till 28. I en variant där tio procent av den ursprungliga träningsdatan sparades i varje generation blev försämringen liten.
Experimentet visar alltså vad som händer när modellernas egen text helt tar över, inte när den blandas med mänsklig text.
Ersätta eller lägga till
En forskargrupp med Matthias Gerstgrasser och Rylan Schaeffer prövade just den skillnaden i en studie från april 2024. De bekräftar att kollapsen kommer när varje generations syntetiska data ersätter den verkliga datan. Men när de syntetiska generationerna i stället ackumuleras bredvid originaldatan undviks kollapsen. Teoretiskt visar de att felet då har ett övre tak, oavsett hur många generationer som tränas. Resultatet höll för flera modellstorlekar och arkitekturer, och för andra modelltyper än språkmodeller.
Enligt forskarna är det också den uppställning som ligger närmast verkligheten. Den mänskliga text som fanns på webben 2021 försvinner inte för att nya sidor skrivs av maskiner. Arkiven finns kvar, och nästa träningsomgång kan använda både gammalt och nytt material.
Ändå är frågan inte avgjord. Elvis Dohmatob och medförfattare visade i oktober 2024 att redan en liten andel syntetisk data, så lite som en procent av träningsmaterialet, kan ge kollaps i deras uppställning. Mer träningsdata hjälpte inte. Större modeller kunde till och med förstärka problemet, även om de bortom en viss storlekströskel kunde mildra det. Studien bygger på en förenklad teoretisk modell med kompletterande experiment, och den säger inte att dagens stora språkmodeller har kollapsat. Den visar att ackumulering inte automatiskt är ett skydd.
Det ovanliga försvinner först
Gemensamt för studierna är var skadan syns först. En språkmodell som genererar text väljer oftare det sannolika än det osannolika. När nästa modell lär sig av den texten är det ovanliga redan underrepresenterat, och efter några varv saknas det nästan helt. Medelvärdena påverkas sent. Därför kan en modell i tidig kollaps prestera bra på vanliga test och ändå ha tappat de sällsynta fallen.
Vad som ligger i svansarna är redaktionens tolkning och inget som studierna mäter, men listan är inte svår att föreställa sig: specialkunskap som bara beskrivs på ett fåtal sidor, regionala uttryck, minoritetsperspektiv och språk med litet textunderlag. Det som riskerar att försvinna är alltså inte det som gör en modell användbar för de flesta, utan det som gör den användbar för de få.
Två mätningar, två svar
Hur mycket av webben som redan är maskinskriven beror på vad som räknas. Under 2026 har två mätningar fått spridning, och de ger svar som skiljer sig med en faktor två.
| Visokay m.fl. (preprint, okt 2026) | Graphite (maj 2026) | |
|---|---|---|
| Vad som mäts | Sidor med AI-genererad eller AI-redigerad text | Nya artiklar som huvudsakligen är AI-genererade |
| Urval | 5,1 miljoner sidor, 505 974 domäner, alla språk | 55 400 engelskspråkiga artiklar |
| Period | Jan 2019–aug 2026 | Jan 2020–mars 2026 |
| Senaste värde | 24 % (aug 2026) | 49,9 % (första kvartalet 2026) |
Skillnaden är i huvudsak en skillnad mellan bestånd och flöde. Graphite mäter vad som publiceras som nya artiklar, och där har andelen legat kring hälften sedan början av 2025: 49,6 procent första kvartalet 2025, 50,9 procent fjärde kvartalet och 49,9 procent första kvartalet 2026. Visokay och kollegor mäter vad som finns på crawlbara sidor vid varje tidpunkt, inklusive äldre sidor. Graphite räknar dessutom bara artiklar som huvudsakligen är maskinskrivna, medan den andra studien också räknar sidor med AI-redigerad text.
Preprintstudien innehåller två detaljer som har betydelse för träningsdatan. Andelen AI-text var nästan dubbelt så hög på sidor som bara är på engelska, 32,8 procent, som på sidor helt utan engelska, 17,0 procent. Och andelen var högst bland de minst centrala sidorna i webbens länkstruktur, 27,5 procent, mot 11,6 procent bland de mest centrala. Maskintexten är alltså vanligast i webbens periferi, dit få länkar pekar. Ökningstakten har också stigit, från 4,6 procentenheter per år mellan början av 2023 och början av 2025 till 8,1 därefter.
Båda mätningarna vilar på detektorer, program som bedömer om en text är maskinskriven. De felar. I Graphites kontroll mot text skriven före ChatGPT klassade de tre detektorerna mellan 1,4 och 1,8 procent av mänsklig text som AI. Preprintstudien korrigerar för sådana fel med en statistisk modell och kontrollmaterial från före 2022, men siffrorna är skattningar och inte räkningar. Studien är dessutom inte referentgranskad.
Mänsklig text blir en knapp råvara
Shumailov och kollegor drar en slutsats som pekar framåt: data om verkliga mänskliga interaktioner kommer att bli allt mer värdefulla när webben fylls av text från språkmodeller. Med var fjärde sida och hälften av de nya engelskspråkiga artiklarna har den slutsatsen fått en tydligare innebörd.
Den som tränar modeller kan hantera risken på tre sätt, som alla följer av forskningen ovan. Det första är att behålla det gamla: arkiv från före 2022 är ett material som inte kan förorenas i efterhand. Det andra är att sortera det nya, vilket kräver detektorer som felar åt båda hållen. Ett falsklarm på ett par procent betyder att en del mänsklig text kastas bort, och en missad maskintext följer med in i träningen. Det tredje är att hitta text med känt ursprung, där det går att belägga att en människa har skrivit den.
Alla tre gör träningsdatans härkomst till en tillgång. Den som har ett stort arkiv av mänsklig text eller en kanal där människor skriver får ett försprång som inte beror på bättre algoritmer.
Vad som inte är visat
Forskningen visar inte att dagens stora språkmodeller har börjat kollapsa. Experimentet i Nature gjordes med en liten modell och en extrem uppställning. Det motsatta resultatet, att ackumulering skyddar, och invändningen att även små inslag kan skada, bygger båda på förenklade teoretiska modeller och begränsade experiment. Mätningarna av webben visar hur vanlig maskintexten är, inte vilken effekt den har på modeller som tränas på den.
Det som är visat är mekanismen i experimenten och riktningen i mätningarna. Andelen maskintext i råvaran ökar, och det som försvinner först när modeller lär sig av varandra är det ovanliga. Det är svårt att upptäcka med de test som mäter genomsnittlig prestanda.
FAQ
Vad är modellkollaps?
Att modeller som tränas på text från tidigare modeller gradvis försämras. Enligt Shumailov och kollegor i Nature 2024 försvinner först det ovanliga i materialet, och i ett senare stadium liknar modellens fördelning originalet dåligt.
Har dagens stora språkmodeller kollapsat?
Det visar inte forskningen. Experimentet i Nature gjordes med en liten modell i en extrem uppställning där modellernas egen text helt ersatte originaldatan.
Går modellkollaps att undvika?
När syntetisk data läggs till bredvid den ursprungliga datan i stället för att ersätta den undviks kollapsen enligt Gerstgrasser och kollegor. En annan studie visar att även en liten andel syntetisk data kan ge kollaps i en förenklad modell, så frågan är inte avgjord.
Hur stor del av webben är AI-genererad?
En preprint från oktober 2026 skattar att 24 procent av de crawlbara webbsidorna innehöll AI-genererad eller AI-redigerad text i augusti 2026. Graphite fann att 49,9 procent av nya engelskspråkiga artiklar första kvartalet 2026 var huvudsakligen AI-genererade.
// Källor och referenser
- AI models collapse when trained on recursively generated data, Nature 631, 755–759 (Shumailov m.fl.), 24 juli 2024.
- Is Model Collapse Inevitable? Breaking the Curse of Recursion by Accumulating Real and Synthetic Data, arXiv 2404.01413 (Gerstgrasser m.fl.), 1 apr. 2024.
- Strong Model Collapse, arXiv 2410.04840 (Dohmatob m.fl.), 7 okt. 2024.
- The Uneven Rise of AI-Generated Web Content, arXiv 2610.36631 (Visokay m.fl.), preprint, 27 okt. 2026.
- AI Now Writes as Many Online Articles as Humans, Graphite, 15 maj 2026.
Få AI-burkens nya analyser via e-post
Du får först ett mejl där du bekräftar adressen. Varje nyhetsbrev har en länk för att avsluta prenumerationen.
Adressen sparas av AI-burken och används bara för nyhetsbrevet. Läs integritetspolicyn