När koden skriver koden – vem äger morgondagens sårbarheter?
AI-assistenter skriver allt mer kod, och forskningen visar att de skriver in sårbarheter. Juridiskt är ansvaret tydligt – i praktiken saknar det ofta adress.
Av Redaktionen
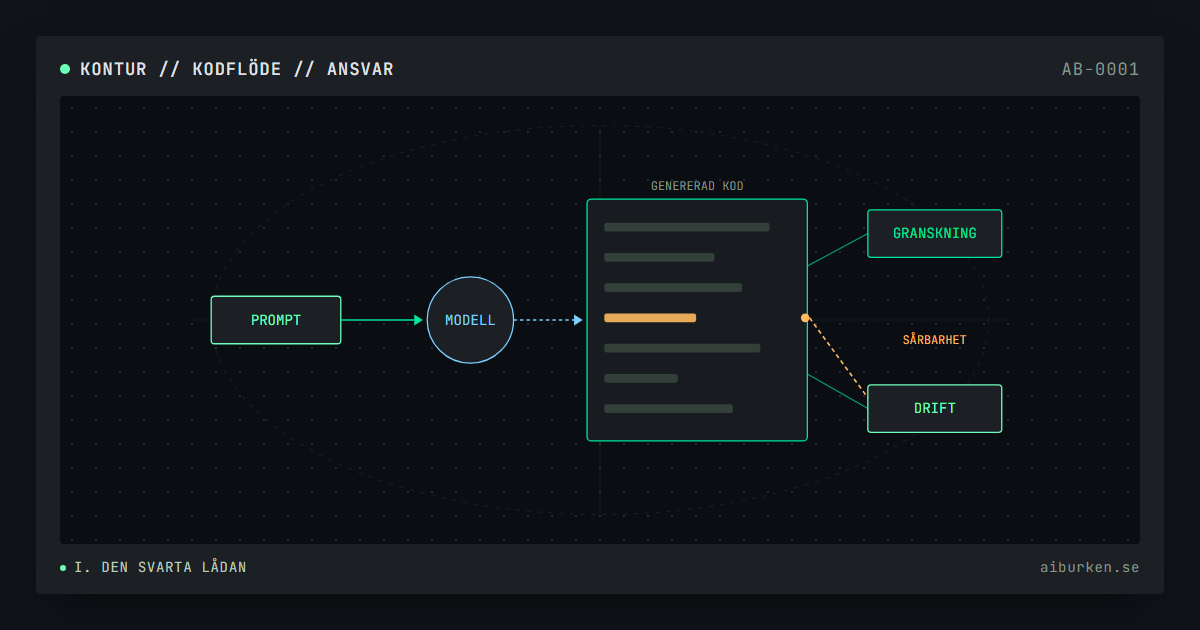
En utvecklare ber sin kodassistent om en funktion som kontrollerar en inloggningstoken. Förslaget ser rimligt ut, testerna går igenom och granskaren godkänner ändringen på några minuter. Ett halvår senare visar det sig att funktionen accepterar tokens som aldrig signerats. Vem skrev felet? Modellen som föreslog koden, utvecklaren som tog emot den, granskaren som godkände den – eller organisationen som köpte verktyget och mätte teamet på hur snabbt det levererade?
AI-assisterad utveckling har på några år gått från experiment till vardag, även i organisationer som bygger system för banker, myndigheter och kritisk infrastruktur. Det påverkar hur fort programvara skrivs, men också hur många som förstår den.
Vad forskningen faktiskt visar
En av de första större säkerhetsgranskningarna av en kodassistent kom 2021 och presenterades vid IEEE:s säkerhetssymposium 2022. Forskare vid bland annat New York University lät GitHub Copilot skriva kod i 89 scenarier som var konstruerade kring kända svaghetsklasser och fick fram 1 689 program. Ungefär 40 procent av dem innehöll sårbarheter. Studien sa inget om hur ofta sådan kod hamnar i produktion, men den visade att modellen gärna återger de mönster den sett – även de osäkra.
Året därpå kom en studie från Stanford som flyttade fokus från maskinen till människan. Deltagare som fick använda en AI-assistent skrev i flera uppgifter kod som var mindre säker än kontrollgruppens. De var samtidigt mer benägna att tro att deras kod var säker. Det är kombinationen som oroar: sämre kod och större tilltro till den.
Senare mätningar pekar åt samma håll. Säkerhetsföretaget Veracode testade 2025 över hundra språkmodeller på 80 programmeringsuppgifter där det fanns både ett säkert och ett osäkert sätt att lösa uppgiften. I 45 procent av fallen valde modellerna det osäkra. För Java var andelen över 70 procent, och skydd mot cross-site scripting saknades i 86 procent av de relevanta fallen. I 2025 års rapport noterade företaget dessutom att nyare modeller blivit bättre på att skriva kod som fungerar, men inte märkbart bättre på att skriva kod som är säker. Veracode säljer säkerhetsgranskning, vilket är skäl att läsa siffrorna med viss försiktighet – men de stämmer väl med den oberoende forskningen.
Paket som inte finns
En ny typ av risk har också uppstått. Språkmodeller hittar ibland på namn på programbibliotek som inte existerar. En studie som presenterades vid USENIX Security 2025 genererade 576 000 kodexempel med 16 modeller och fann att i genomsnitt minst 5,2 procent av de paket som kommersiella modeller föreslog inte fanns. För öppna modeller var andelen 21,7 procent. Totalt registrerades 205 474 unika påhittade paketnamn.
Det låter som en kuriositet tills man inser att vem som helst kan registrera ett sådant namn i ett paketregister och fylla det med skadlig kod. Den som installerar det modellen föreslog, utan att kontrollera att paketet är det man tror, har då öppnat dörren själv. Attacken har fått namnet slopsquatting, och den kräver ingen sårbarhet i någon kod – bara en hallucination och en utvecklare som har bråttom.
Snabbare – eller känns det bara så?
Argumentet för att acceptera riskerna är produktiviteten. Även här är bilden mer komplicerad än marknadsföringen. Forskningsorganisationen METR genomförde 2025 en randomiserad studie med 16 erfarna utvecklare som arbetade med 246 verkliga uppgifter i stora öppna kodbaser de själva kände väl. När de fick använda AI-verktyg tog uppgifterna i genomsnitt 19 procent längre tid. Före studien hade deltagarna räknat med att bli 24 procent snabbare, och efteråt trodde de att de hade blivit omkring 20 procent snabbare.
Studien är liten, verktygen har utvecklats sedan dess och andra mätningar har visat tidsvinster i andra sammanhang. METR påpekar själva att resultatet inte gäller alla situationer. Men gapet mellan upplevd och uppmätt effekt är värt att stanna vid. Om utvecklare systematiskt överskattar hur mycket verktyget hjälper, är det inte heller självklart att de korrekt bedömer hur mycket det skadar.
Teknisk skuld utan upphovsperson
Teknisk skuld brukar beskrivas som priset för genvägar: kod som fungerar i dag men blir dyr att ändra i morgon. Med AI-genererad kod tillkommer en ny form av skuld som har mindre med kodens kvalitet att göra än med förståelsen av den. När ingen i teamet själv har resonerat fram en lösning finns det heller ingen som minns varför den ser ut som den gör, vilka antaganden den bygger på eller vilka fall den inte hanterar.
Det slår igenom i granskningen. Kodgranskning har alltid varit ett sätt att sprida förståelse lika mycket som att hitta fel. När mängden föreslagen kod ökar snabbare än antalet granskare, och koden dessutom ser prydlig och självsäker ut, förskjuts granskningen från förståelse till stickprov. Det säger mindre om enskilda granskare än om en arbetsmiljö där det är lätt att godkänna det man inte helt har förstått.
Den farligaste koden är inte den som ser fel ut. Det är den som ser rätt ut och som ingen har anledning att läsa en gång till.
Lagen frågar inte vem som skrev koden
Juridiskt är frågan om ansvar enklare än den verkar, och det är en del av problemet. Varken EU:s cyberresiliensförordning eller det nya produktansvarsdirektivet gör skillnad på kod som skrivits av en människa och kod som föreslagits av en modell. Ansvaret ligger hos den som släpper ut produkten.
EU:s cyberresiliensförordning, Cyber Resilience Act, gäller produkter med digitala element. Sedan den 11 september 2026 måste tillverkare rapportera aktivt utnyttjade sårbarheter och allvarliga incidenter: en tidig varning inom 24 timmar, en anmälan inom 72 timmar och för sårbarheter en slutrapport senast 14 dagar efter att en åtgärd finns tillgänglig. Rapporterna lämnas via EU:s cybersäkerhetsbyrå Enisas gemensamma plattform. De flesta övriga krav, bland annat på säker utveckling, sårbarhetshantering och en förteckning över ingående programkomponenter, gäller från december 2027.
Samtidigt ska medlemsstaterna senast den 9 december 2026 ha genomfört EU:s nya produktansvarsdirektiv, som uttryckligen räknar programvara som en produkt. Fri och öppen programvara som utvecklas utanför kommersiell verksamhet undantas, men den tillverkare som bygger in sådan programvara i en kommersiell produkt ansvarar för den på samma sätt som för produkten i övrigt.
Konsekvensen är att den som släpper ut en produkt som omfattas av reglerna inte kan lämpa över något ansvar på kodassistenten. Den genererade koden är organisationens egen kod, med samma rapporteringsplikt och samma skadeståndsrisk som om en anställd skrivit den på fri hand. Skillnaden är att organisationen kanske inte vet vilka delar av kodbasen som har det ursprunget.
Det som måste vägas upp
Inget av detta talar för att förbjuda verktygen. Det talar för att behandla dem som det de är: en ny och produktiv men opålitlig leverantör av kod. Flera av motåtgärderna är gamla, men de behöver tillämpas med en annan disciplin.
- Behandla genererad kod som tredjepartskod. Den ska granskas med samma misstänksamhet som ett okänt bibliotek, inte med den välvilja man visar en kollega.
- Verifiera varje nytt beroende. Kontrollera att paketet finns, vem som publicerat det och hur länge det funnits innan det installeras. Lås versioner och kontrollsummor.
- Gör säkerhetskraven körbara. Tester som uttryckligen prövar att osignerade tokens avvisas, att indata saneras och att behörigheter kontrolleras fångar det som en snabb granskning missar.
- Automatisera det tråkiga. Statisk analys och beroendeskanning i varje bygge är billigare än en rapport inom 24 timmar.
- Dokumentera ursprunget. Den som vet vilka delar av kodbasen som genererats vet också var granskningen behöver vara som noggrannast när en sårbarhet upptäcks.
- Mät rätt sak. Ett team som belönas för antal sammanslagna ändringar kommer att granska mindre. Ett team som belönas för färre incidenter kommer att granska mer.
Ägandet går inte att automatisera
Den som frågar vem som äger morgondagens sårbarheter får ett tydligt juridiskt svar: den som släpper ut programvaran. Det svåra är att göra det svaret sant i praktiken. Det kräver att någon i organisationen faktiskt förstår den kod man ansvarar för, och det är just den förståelsen som AI-assisterad utveckling gör billigare att hoppa över.
Kodassistenterna kommer att bli bättre. Men så länge de lär sig av den kod som redan finns kommer de också att lära sig av dess misstag, och så länge de låter säkra kommer människor att lita på dem. Ansvaret för morgondagens sårbarheter kan inte delegeras till en modell. Det kan bara tas – eller lämnas utan adress.
FAQ
Är AI-genererad kod mindre säker än kod som människor skriver?
I en studie från Stanford skrev deltagare med AI-assistent i flera uppgifter mindre säker kod än kontrollgruppen, och de trodde oftare att deras kod var säker. Andra studier mäter modellerna utan jämförelse med människor: i en granskning från 2021 innehöll ungefär 40 procent av 1 689 program som GitHub Copilot skrev sårbarheter, och i Veracodes test 2025 valde språkmodellerna den osäkra lösningen i 45 procent av fallen.
Vad är slopsquatting?
Ett angrepp där någon registrerar ett paketnamn som en språkmodell har hittat på och fyller paketet med skadlig kod. Den som installerar paketet utan att kontrollera det installerar angriparens kod. I en studie som presenterades 2025 fanns minst 5,2 procent av de paket som kommersiella modeller föreslog inte, och för öppna modeller var andelen 21,7 procent.
Vem ansvarar för sårbarheter i AI-genererad kod?
Den som släpper ut produkten. Varken EU:s cyberresiliensförordning eller det nya produktansvarsdirektivet gör skillnad på kod som en människa har skrivit och kod som en modell har föreslagit. För den som släpper ut en produkt som omfattas av reglerna är den genererade koden organisationens egen.
Vad kräver cyberresiliensförordningen sedan september 2026?
Sedan den 11 september 2026 ska tillverkare rapportera aktivt utnyttjade sårbarheter och allvarliga incidenter: en tidig varning inom 24 timmar och en anmälan inom 72 timmar. För sårbarheter ska en slutrapport lämnas senast 14 dagar efter att en åtgärd finns tillgänglig. De flesta övriga krav gäller från december 2027.
Hur minskar man riskerna med AI-genererad kod?
Behandla den som tredjepartskod. Kontrollera att varje nytt paket finns och vem som har publicerat det, lås versioner och kontrollsummor, skriv tester som prövar säkerhetskraven och kör statisk analys och beroendeskanning i varje bygge.
// Källor och referenser
- Asleep at the Keyboard? Assessing the Security of GitHub Copilot's Code Contributions, Pearce m.fl., IEEE Symposium on Security and Privacy 2022.
- Do Users Write More Insecure Code with AI Assistants?, Perry m.fl., ACM CCS 2023.
- 2025 GenAI Code Security Report, Veracode, 30 juli 2025.
- We Have a Package for You! A Comprehensive Analysis of Package Hallucinations by Code Generating LLMs, Spracklen m.fl., USENIX Security 2025.
- Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, METR, 10 juli 2025.
- Förordning (EU) 2024/2847 om horisontella cybersäkerhetskrav för produkter med digitala element (Cyber Resilience Act), EUR-Lex.
- CRA reporting obligations, Europeiska kommissionen.
- Direktiv (EU) 2024/2853 om skadeståndsansvar för produkter med säkerhetsbrister, EUR-Lex.
Få AI-burkens nya analyser via e-post
Du får först ett mejl där du bekräftar adressen. Varje nyhetsbrev har en länk för att avsluta prenumerationen.
Adressen hanteras av Brevo för AI-burkens räkning. Läs integritetspolicyn