Öppen AI som demokratiskt värn – behöver Sverige egna AI-burkar?
Sverige vill ha egna språkmodeller och mer beräkningskraft. Kan öppna AI-modeller på egen infrastruktur minska beroendet av ett fåtal globala jättar?
Av Redaktionen
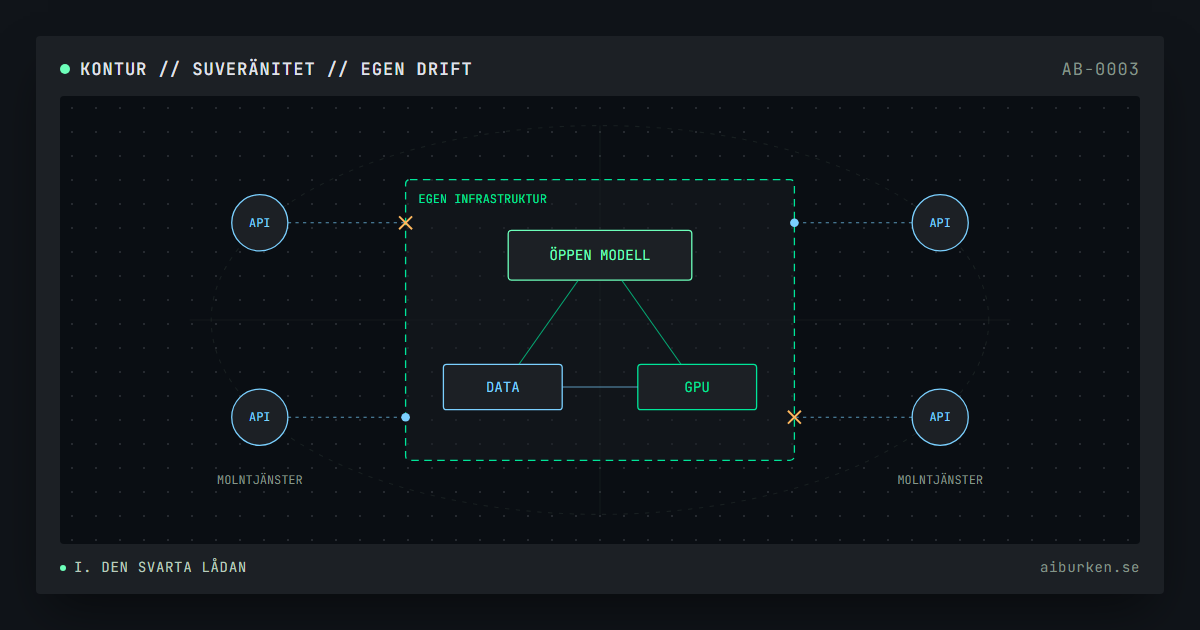
I serverhallar talar man om burkar: lådorna i racket där processorerna arbetar. När en svensk myndighet låter en språkmodell sammanfatta ett ärende sker beräkningen oftast i någon annans burk, inte sällan hos en leverantör som lyder under en annan lagstiftning. Det fungerar så länge villkoren är stabila. Frågan är vad som händer den dag de inte är det.
Det är ingen abstrakt fråga längre. Sveriges AI-strategi, som regeringen beslutade i februari 2026, slår fast att landets digitala sårbarhet måste minska samtidigt som tillgången till säkra tekniska plattformar säkerställs. I samma strategi kopplas behovet av svenska språkmodeller uttryckligen till Sveriges digitala suveränitet. Det väcker en konkret följdfråga: behöver Sverige egna AI-burkar?
Var beroendet sitter
De mest använda AI-tjänsterna drivs av ett fåtal företag, och de flesta av dem är amerikanska. Beroendet har flera lager. Det första är tekniskt: modellen, beräkningskraften och programvaran runt den finns hos leverantören. Det andra är kommersiellt: priser, villkor och tillgång kan ändras ensidigt. Det tredje är juridiskt, och det är det som oftast underskattas.
Den amerikanska CLOUD Act från 2018 gör det möjligt för amerikanska myndigheter att under vissa förutsättningar begära ut uppgifter från amerikanska tjänsteleverantörer, oavsett var i världen uppgifterna lagras. För svensk offentlig sektor har det väckt frågan om sekretess: när ska sekretessbelagda uppgifter anses röjda om de lämnas till en leverantör? Många beslut om utkontraktering har utgått från eSamverkansprogrammets definition, enligt vilken uppgifterna inte är röjda om avtalet är hållbart utformat och det är osannolikt att leverantören tar del av dem. Den statliga it-driftsutredningen, SOU 2021:1, gjorde en strängare bedömning: en myndighet som utkontrakterar it-drift har lämnat ut uppgifterna, även om de är krypterade, och uppgifterna är därmed röjda. Utredningen föreslog därför en ny sekretessbrytande bestämmelse. Frågan blir inte enklare när det som skickas till tjänsten är hela ärenden snarare än enstaka filer.
Till detta kommer geopolitiken. Avancerade AI-chip omfattas av exportkontroller, och reglerna har ändrats flera gånger på kort tid. Den som har byggt sin verksamhet på att tillgången till beräkningskraft är en ren marknadsfråga har fått anledning att tänka om.
Vad öppen betyder – och inte betyder
Under de senaste åren har allt fler kraftfulla modeller släppts med öppna vikter: de inlärda parametrarna går att ladda ner och köra på egen hårdvara. Det gäller modeller från europeiska, kinesiska och amerikanska utvecklare. När OpenAI i augusti 2025 släppte gpt-oss under licensen Apache 2.0 var det företagets första modeller med öppna vikter sedan 2019. Den mindre av de två modellerna kan köras på en dator med 16 gigabyte minne, den större på ett enda grafikkort med 80 gigabyte.
Öppna vikter är ändå inte detsamma som öppen källkod. Open Source Initiative publicerade i oktober 2024 en definition av öppen AI som kräver mer: inte bara vikterna, utan även koden för träning och körning och en utförlig beskrivning av träningsdatan, dess ursprung och hur den har bearbetats. De flesta modeller som marknadsförs som öppna uppfyller inte de kraven. Licenserna varierar också, från tillåtande licenser som Apache 2.0 till egna villkor med begränsningar för vissa användare eller användningsområden.
Skillnaden spelar roll för suveräniteten. En modell med öppna vikter går att köra utan att fråga någon om lov, och den kan inte stängas av utifrån. Men den som inte vet vad modellen har tränats på vet inte heller vilka värderingar, luckor eller medvetna begränsningar den har med sig. Öppna vikter ger kontroll över driften, inte över innehållet.
Vad Sverige redan gör
Den svenska politiken har rört sig snabbt de senaste två åren. AI-kommissionen lämnade sin färdplan i november 2024 och föreslog satsningar på 16,7 miljarder kronor över tio år, bland dem utbyggd beräkningskapacitet, även för att köra färdiga modeller. Samma år valde EU:s gemensamma företag för superdatorer, EuroHPC, Sverige som värd för en av de första europeiska AI-fabrikerna. Fabriken, Mimer, finns vid Linköpings universitet. I april 2026 tecknades kontraktet för en ny AI-optimerad superdator till anläggningen, finansierad till hälften av EuroHPC och till hälften av Vetenskapsrådet.
AI-strategin från februari 2026 sätter målet att Sverige ska vara bäst i världen på att använda AI i den offentliga förvaltningen, och under 2026 inleds arbetet med en nationell AI-verkstad för förvaltningen som ska vara fullt utbyggd 2030. I maj 2026 utsåg regeringen en nationell samordnare för svenska språkmodeller, med uppdrag att påskynda utvecklingen av modeller som speglar svenska kulturella, samhälleliga och juridiska förhållanden. I uppdraget ingår att analysera hur en eventuell ersättning till rättighetshavare kan utformas när upphovsrättsligt skyddat material används för att utveckla modellerna. Samordnaren ska redovisa sitt uppdrag senast den 30 april 2029.
Det är alltså inte brist på initiativ som är problemet. Frågan är vad initiativen ska åstadkomma.
En svensk modell eller svensk kontroll?
Det finns två olika ambitioner som ofta blandas ihop. Den ena är att bygga en egen svensk grundmodell, tränad från början på svensk text. Den andra är att kunna köra kvalificerade modeller – egna eller andras – på infrastruktur under svensk kontroll, med svensk data och under svensk lag.
Den första ambitionen är dyr och osäker. Att träna en grundmodell som kan mäta sig med de bästa kräver beräkningskraft, data och kompetens i en skala som få länder har, och modellen riskerar att vara omsprungen när den är klar. Den har ändå ett värde: en modell som har tränats på svenska förhållanden, och vars träningsdata är känd, går att granska på ett sätt som en importerad modell inte gör.
Den andra ambitionen är billigare och mer omedelbart användbar. En öppen modell som körs i en svensk datahall kan anpassas till svenska ärendetyper, utvärderas mot svenska behov och användas för sekretessbelagd information utan att uppgifterna lämnar landet. Den löser inte frågan om vad modellen har lärt sig, men den löser frågan om vem som har tillgång till det man frågar den om.
| Molntjänst från global leverantör | Öppen modell i egen drift | |
|---|---|---|
| Kontroll över data | Hos leverantören, under dess jurisdiktion | Hos den egna organisationen |
| Modellens förmåga | Oftast den högsta tillgängliga | Ofta något lägre |
| Kostnadsprofil | Löpande avgift per användning | Investering i hårdvara, el och kompetens |
| Uppdatering | Sker automatiskt, även när man inte vill | Sker när man själv väljer, och måste därför göras |
| Avbrottsrisk | Villkor, priser och export kan ändras utifrån | Drift, säkerhet och bemanning är det egna ansvaret |
Egen drift är inget gratis val
Den som tar hem en modell tar också hem ansvaret. En lokal modellserver måste skyddas som vilken annan tjänst som helst, och en server som av misstag är nåbar från internet är lika exponerad som en öppen databas. Modellfiler är programvara och måste behandlas så: de ska hämtas från kända källor, kontrolleras och hållas uppdaterade. Den kompetens som krävs för att göra det väl är bristvara, även i stora organisationer.
Det talar för att egen drift i offentlig sektor inte bör byggas myndighet för myndighet. Gemensam infrastruktur, som AI-fabriken i Linköping och den planerade AI-verkstaden, kan ge mindre organisationer tillgång till både beräkningskraft och kompetens utan att var och en behöver bygga sin egen hall.
Suveränitet är förmågan att välja
Svaret på rubrikens fråga är ja – men inte i betydelsen att Sverige ska klara sig utan de globala leverantörerna. Det är varken möjligt eller önskvärt. Digital suveränitet handlar om att ha ett verkligt alternativ: att kunna flytta en tjänst, byta leverantör eller köra en modell själv när villkoren kräver det.
För att det ska vara möjligt krävs några saker som inte är tekniskt spektakulära. Upphandlingar som ställer krav på att data och anpassningar kan föras över till ett annat system. Utvärderingar av modeller mot svenska uppgifter, så att valet av modell grundas på mätningar och inte på marknadsföring. Beräkningskapacitet under svensk kontroll för den information som inte bör lämna landet. Och en öppenhet kring träningsdata som gör det möjligt att veta vad man faktiskt kör.
Öppna modeller i egna burkar är inget demokratiskt värn i sig. De är ett verktyg som gör det möjligt att säga nej. I en tid när villkoren för teknik kan förändras med ett presidentbeslut eller en ny exportregel är det ingen liten sak.
FAQ
Vad är skillnaden mellan öppna vikter och öppen källkod?
En modell med öppna vikter går att ladda ner och köra på egen hårdvara. Open Source Initiatives definition av öppen AI från oktober 2024 kräver mer: även koden för träning och körning och en utförlig beskrivning av träningsdatan. De flesta modeller som marknadsförs som öppna uppfyller inte de kraven.
Vad betyder CLOUD Act för svensk offentlig sektor?
Den amerikanska lagen från 2018 gör det möjligt för amerikanska myndigheter att under vissa förutsättningar begära ut uppgifter från amerikanska tjänsteleverantörer, oavsett var uppgifterna lagras. Det har väckt frågan om när sekretessbelagda uppgifter ska anses röjda om de lämnas till en leverantör. Många beslut har utgått från eSamverkansprogrammets definition, där uppgifterna inte är röjda om det är osannolikt att leverantören tar del av dem. Den statliga utredningen SOU 2021:1 bedömde i stället att utkontraktering av it-drift innebär att uppgifterna är röjda, och föreslog en ny sekretessbrytande bestämmelse.
Vad gör Sverige för att få egna svenska språkmodeller?
Regeringen utsåg i maj 2026 en nationell samordnare för svenska språkmodeller, som ska redovisa sitt uppdrag senast den 30 april 2029. Sverige är också värd för AI-fabriken Mimer vid Linköpings universitet, där en ny AI-optimerad superdator finansieras till hälften av EuroHPC och till hälften av Vetenskapsrådet.
Går det att köra en öppen språkmodell på egen hårdvara?
Ja, de mindre modellerna. Den mindre av OpenAI:s två gpt-oss-modeller kan köras på en dator med 16 gigabyte minne, medan den större kan köras på ett enda grafikkort med 80 gigabyte. Egen drift innebär också eget ansvar för säkerhet, uppdateringar och kompetens.
Behöver Sverige en egen grundmodell för digital suveränitet?
Inte nödvändigtvis. En egen grundmodell är dyr och riskerar att vara omsprungen när den är klar. Att kunna köra öppna modeller på infrastruktur under svensk kontroll ger mycket av samma skydd för känsliga uppgifter, även om det inte löser frågan om vad modellen har lärt sig.
// Källor och referenser
- Sveriges AI-strategi på fem minuter, Regeringskansliet, 20 feb. 2026.
- En nationell samordnare för svenska språkmodeller (Dir. 2026:32), Regeringskansliet.
- Regeringen utser nationell samordnare för svenska språkmodeller, Regeringskansliet.
- AI-kommissionen vill att Sverige satsar, Linköpings universitet, 26 nov. 2024.
- Sweden is establishing an AI Factory with the support of EuroHPC JU, Vetenskapsrådet, 10 dec. 2024.
- EuroHPC JU signs contract to deploy new AI-optimised supercomputer in Sweden, EuroHPC JU, 21 apr. 2026.
- The Open Source AI Definition 1.0, Open Source Initiative, 28 okt. 2024.
- OpenAI makes good on its name, launches first open weights language models since GPT-2, The Register, 5 aug. 2025.
- Congress Passes CLOUD Act to Facilitate Law Enforcement Access to Overseas Data, Jones Day, 27 mars 2018.
- Säker och kostnadseffektiv it-drift – rättsliga förutsättningar för utkontraktering (SOU 2021:1), Statens offentliga utredningar.
- SOU 2021:1, sammanfattning (bilaga till remissärende), Nacka kommun.
- Remissvar över SOU 2021:1, Region Västerbotten.
Få AI-burkens nya analyser via e-post
Du får först ett mejl där du bekräftar adressen. Varje nyhetsbrev har en länk för att avsluta prenumerationen.
Adressen hanteras av Brevo för AI-burkens räkning. Läs integritetspolicyn